❌

阅读视图

发现新文章,点击刷新页面。

爱拯救之

极客死亡计划现在运行在安装 OpenBSD 8.0 的服务器上,不是 Linux。

我在 第一百零一期周刊 因 Linux 如今也包含 LLM 生成的代码而感到沮丧,写道:“我用 Linux,不可能不用”——结果,我还真的可以不用。Linus Torvalds 最近还在 邮件列表 里回复一条我读起来毫无恶意的邮件,用十分荒唐的逻辑称对方的想法愚蠢之极(“UTTERLY STUPID”),语气强烈。

前不久 ,他用 Claude Code 写的代码被评审者找出潜在的竞态问题(race condition)。 再后来 ,Linux 内核不再要求贡献者披露 LLM 使用情况。

这一切都给了我更多的理由抛弃 Linux,去用 BSD。我们讨论的不是可有可无的 SaaS 软件,我们说的是 Linux,全世界都依赖的操作系统。

Oh Linus, oh Linus, you let us all down.

不少 LLM 追捧者貌似只有那么一两个论点,Linus 一边骂人一边强调“LLM 是工具”,与此同时,Rich Hickey1 说: 我一辈子都在造工具和用工具,我知道工具是什么。LLM 可不是工具。 与此同时,OpenBSD 发布了一首名为《 The Simps on AI 》的歌曲,我意犹未尽地听了好几遍。与此同时,还有 一群没那么显眼的人 想要负责任地维护让人感到安心的软件系统。

说真的,我还在乎那些破事儿干嘛呢?

前几天我在英文博客发了一篇题为《 What’s next for the indie web? 》的文章,介绍了 weepinbell 的理念和架构设计,还谈了谈我认为独立网站不应该集中在 IndieWeb 以及 Aaron Parecki 提供的基础设施上(比如 webmention.io)。我的想法是,除了 IndieWeb camp,还应该有更多有活力的小社群。社群内(或社群之间)可以共享基础设施,由一两个有能力、有责任心的人维护诸如联邦宇宙实例、页面托管和 Webmention 接收器等基础设施,这样的社群应该是由相似理念和爱好的人组成。

这样大家可以一起远离充斥推荐算法和广告的商业平台,又不容易感到自己在孤军奋战,可以相互提供帮助,或者各司其职。不同的基础设施可以由社群里不同的人维护,兴许还能合作推出公开的软件或服务,不懂技术的人还能在美术等方面提供帮助。除了扁平的结构,也可以像 IndieWeb camp 那样,有一两个扛大旗的志愿者,但仍然与社群联系紧密。

这样的互联网社群已经有一些案例了,涛叔的 ZZ.AC 兴许就算其中一种,国外我比较有好感的是 omg.lol 。此外还有一些比较特立独行、小众且观点鲜明的,比方说 OpenBSD Amsterdam ——尽管看上去是云计算提供商,但社群的确很有活力,我在找 OpenBSD 的参考资料的时候也偶尔会路过他们写的页面。就算不考虑独立网站的概念,一两个有能力的人带头组建起和谐的小社群,这样的例子也有不少,氛围都要比乌烟瘴气的「大互联网」好太多。

我的确有很强烈的自我意识和难以改变的价值观(与我有邮件通信的朋友将其称作「工匠精神」,其实我有点不敢当,但我的确很在乎工艺之类的概念),以至于我时常绝望地在心里大吼,这个世界怎么变得这么坏?最近这种负面情绪变得愈发强烈,可以在《 打领带的人 》里读到。我和这个世界就是不合的,但这不代表我找不到和我有着一样信念的人。

我想我有点太关注那些与我无关的人的想法和行事方式了,有点像《地狱客栈》第二季的夏莉,那样发起疯来只会让关心自己的人感到难受。如上文所述,有很多人和我站在相似的立场上,我为什么要想象自己身处敌营中,让自己感到困顿、绝望、难以呼吸、无法逃脱?

我也要原谅自己的偏执,因为我“身处敌营”的状况其实并非只是想象:

我观察下来,这个行业里有绝大部分是不爱编程的。

我比较有限的样本里有这几种类型:除了上班不写代码,觉得有 LLM 不用还要自己手写的人是纯傻逼的;写代码是为了开发产品获得商业成功,而同时开好几个 Agent 会话能帮他们“更快达成目标”;对任何事情都没有反思,把 LLM 盛行当作天气现象一样自然的事情,就像世界上有个叫 Java 的编程语言、学校里教这个、也有公司招这个岗,然后就一直写 Java,后来也很自然地融入了 Vibe-coding 的同列;喜欢新奇概念,自称追上行业前沿的,热衷于传播「许愿式编程」之类的概念,对自己的“与时俱进”感到骄傲……

我觉得我能做的就是给工作分配尽可能少的精力,但这好像也很难,我也真的在认真考虑要不要远离这个行业……

我唯一应该责怪自己的,不是自己对世界的认知,而是我对这种认知的反应。我的反应相当情绪化,我想逃。我说我在考虑要远离这个行业是认真的,一周前我就在物色接收短篇小说投稿的杂志。《零杂志》有专门接收非文学背景投稿的栏目,可惜字数限制八千,我最近写的 小说 大多都超过一万两千字了,我也不愿意删改,而且他们的投稿竟然还要填身份证号码,我可不想自己在网络上的身份与现实身份联系起来。我还看了《花城》,据说编辑是真的会读自由来稿的,想必是如今对文学有热情的人少了,编辑的时间才能分配得过来。

不过也有很俗套甚至搞笑的杂志,《花火》据称偏向青春文学,投稿要求里写的是允许忧伤淡雅,但不允许阴郁沉闷,还严格要求禁止描写中小学生早恋,但是可以暗恋,明明是文艺而非文学。文学要的是真实,可不是什么淡雅,不是迎合你们对“青春”的恶臭想象。我想《啸风山庄》要是投稿给这个杂志,一定会被拒稿,许多文学经典按他们的标准都不合格。

明智地讲,如果我真想要从事文学,我也得先有一份能养活自己的工作,而且要想作品被刊登,就应该去研究某篇杂志过去发表过的作品的风格,依照这个风格去创作。一个新人作者是没有创作自由的,除非他不想吃这口饭,就像一个程序员只能去学行业里其他人都在用的技术,自己的技术兴趣只能当作消遣(除非你的技术兴趣是 Rust、LLM Agent 和模型训练)。

愈发觉得职业选择自由和创作自由以及各种形式的自由,在当今的市场里都是特权。

只有有丰富履历(而不一定是过硬的技术实力)的人才有谈薪酬福利的资本,有自由选择技术栈的权力;普通人只能迎合和学习这些人选择的技术,除非不想要吃饭了。

只有有过丰富作品集的小说家、画家和音乐家才有资本让出版机构来欣赏自己的作品,普通人只能迎合杂志社、出版社、唱片公司的审稿人、编辑、制作人的品味,去创作他们偏好的东西。

我没有要批判的意思,我觉得很合理,但我确实不太能够接受这个局面,不能接受个人必须要谄媚才能在世界中获得一席之地…… 我大概要花时间消化这一点。

所以说到底,我还是很难战胜这个世界的残忍。我思考问题很认真,对待自己在乎的事请也很认真,因此对不合理的现象容忍度非常低。然而我只是个学生,可以说是手无缚鸡之力,只有被管的份。哪怕我的辅导员在我的简历上批注「不知道你那个符号(GitHub Logo)是什么意思」,我也不能指责她「外行指导内行」。她也会继续认为自己反复强调面试进门的时候怎么走路和微笑,是崇高的教育之道。

哪怕我不是个学生,也免不了受人管制。恐怕我要到三四十岁的年纪,才能拥有与我的自我意识相匹配的自由。或许到那个时候也不会有,或许到那个时候,自杀的念头会又一次擒住我,而那一次,它会战胜我。我希望那种事情不要发生。

至少现在,我的理智和热情还能赋予我反叛精神,不至于麻木。

除了没用的肉体自杀和精神逃避,第三种自杀的态度是坚持奋斗,对抗人生的荒谬。

每想到类似的事情,我就会想到加缪的文字。我并没有把加缪当作偶像或导师之类的形象,他自己也不觉得自己是哲学家。的确,她不像黑格尔、海德格尔和胡塞尔那样有严谨的哲学理论,他的文字不是理性主导的。荒诞与爱是加缪作品里连续的主题,他的作品里有种朴素的真实感(尤其是他的遗作《 第一个人 》),让我感到他是个可以接近的人,他写的东西常常包含令我会心一笑的个性。

这种真实感和亲近感,或许就是我对抗荒诞的方式呢?我热爱文学,兴许是出于我骨子里对真实的向往,而获取亲近感的方式,则是和真实的人建立真实的关系,而不是 纠正互联网上那个“错的人” 。


最后,我真的有在考虑建立一个小型、独立的互联网社群,也想要帮助没有技术背景的人建立起独立的互联网身份,不被大科技公司控制。这样的社群不会以 V2EX 和 Hacker News 那样的「大广场」形式存在,更像是各自独立但彼此关联的群岛。我大概会用 weepinbell 搭建公开的 Webmention 服务,我还在考虑自己开发类似 are.na 的平台。

当然,我还在思考,也可能不做。如果你感兴趣,欢迎 给我发邮件 。

希望我们都不要认输。


  1. 编程语言 Clojure 的创造者。 ↩︎

啸风山庄

《啸风山庄》是经典英国文学 Wuthering Heights 的新译本,译者是赖慈芸。这本在大陆更常见的译名是《呼啸山庄》,在台湾的译名是《咆哮山庄》,译者本人是台湾师范大学翻译研究所教授,可以说这个新译本统一了两岸的译名。书中还附上《啸风山庄》的翻译简史,读起来蛮有趣。曾经 Wuthering Heights 还被译作《狭路冤家》《魂归离恨天》,后者给我的感觉是把 Wuthering 理解为冤魂不散的声响(毕竟主要人物凯瑟琳和希斯克利夫死后的鬼魂似乎都在人间游荡),把 Heights 理解成了高空,也是值得品味的译法。

这个译本我通篇读下来,觉得语言很通顺,几乎没有译制腔,也没有过度本土化,注释也很完善。只不过有不少对情节进行解读的注解,我其实觉得有些影响阅读。理想国的装帧也很好看,大小合适,捧起来很舒服,我之前还在飞机的狭窄座椅上读过。在万米高空读 Wuthering Heights,也别有一番韵味了。

对于文学经典,我不好妄下评论,不过我也确实没有批评的话要讲。我很喜欢艾米莉·勃朗特对人物的塑造,只可惜她一生只出版了这一部作品,而且似乎在初次出版时并不受欢迎。她的姐姐夏洛特·勃朗特(《简·爱》的作者)在给再版的《啸风山庄》写序的时候,还为妹妹在书中描写的各种不道德的行径致歉,她没有意识到自己的妹妹写出了一篇杰作。译者导读里写道,如今文学界普遍认为《啸风山庄》的文学造诣要高于《简·爱》。

我读《简·爱》还是小学,如今已经忘干净了,只记得主角很惨,最终没能和爱人在一起,她爱的男人有一个精神病妻子。《简·爱》还被译作《孤女飘零记》,和《魂归离恨天》一样都有悲剧基调。《简·爱》的人物关系看起来不如《啸风山庄》复杂,而且道德水准有点太高了,我就喜欢看扭曲和阴暗的情节。当然《简·爱》也是地位相当的文学经典,包含超越时代的女性主义思想,“夏洛特·勃朗特被誉为在故事里最早使用私我意识的作家”1,这点我也觉得很好,稍早一些文学作品都很少描写人物的自我意识,甚至他们可能没有很强烈的自我意识,即便是《 包法利夫人 》和《 红与黑 》里关于偷情的描写,也见不到对人物复杂心理活动的直接描写。《简·爱》的文学成就有很大一部分就体现在这点上。

那么《啸风山庄》的文学成就呢?好吧,我向来不喜欢讨论文学作品的时代意义和影响,就不勉强自己了,写我自己的感想就好。

非道德性

我向来喜欢看道德处于灰色地带的作品,因为合乎道德的好人谁都写得出来,太过正直反而缺少文学所追求的那种真实——这也是我 不喜欢诺兰导演的《奥德赛》 的原因之一。我想要看到的是真实的人在糟糕的处境下做出两难(甚至三难、更多难)的抉择。道德抉择本质上是伪抉择,让角色从绝对的好和绝对的坏之间选择,完全是耍流氓,谁都知道要选第一个。只会服从定言令式的人怎么会打动人心?

《啸风山庄》的非道德性,主要围绕希斯克利夫(Heathcliff)展开。他被恩萧老爷捡回家之后,因为是黑人,还是身份不明的小孩,所以一直被啸风山庄里的其他人欺负,尤其是与辛德里·恩萧(恩萧家的少爷)结下了梁子,但是与凯瑟琳·恩萧(辛德里的妹妹)是青梅竹马。

后来,辛德里离开山庄,回来时娶了个名叫法兰西斯的女人,诞下一子名为哈里顿。辛德里是在恩萧老爷病逝后才带妻子回家的,可能是怕父亲不赞同婚事。法兰西斯的身份不明,但猜想应该是与恩萧家的乡绅身份不符。辛德里的性格不好,父亲和妻子双双死去后,他一蹶不振,恩萧家逐渐破败,啸风山庄里就出现了这么个神智不清的酒鬼。哈里顿没有受到什么好的照看,有次辛德里甚至把它从楼上丢下来,被希斯克利夫接住了。

希斯克利夫和辛德里的儿子哈里顿之间的关系很奇怪。哈里顿本是啸风山庄的女管家迪恩太太养大,后来迪恩太太跟随小姐凯瑟琳嫁到了鸫翔庄园,便离开了哈里顿。哈里顿受希斯克利夫的影响最深,这孩子性格暴戾(可以说跟他父亲也像吧),似乎是讨厌所有人,就喜欢希斯克利夫,因为希斯克利夫教他说脏话。后来辛德里死了,这孩子就一直跟着希斯克利夫,长大了也没读过书。乡绅的孩子被希斯克利夫养成了个没文化没教养的农民,这就是他报复恩萧家的方式之一。

凯瑟琳与希斯克利夫

希斯克利夫至死都一直爱着青梅竹马凯瑟琳。他们之间的感情很复杂,说是爱恨交织,有过度简化之嫌。凯瑟琳·恩萧在小时候和希斯克利夫一起去鸫翔庄园,也就是林顿一家的大庄园里玩,被林顿家的看门狗咬伤了,在庄园里修养了几个月,而希斯克利夫则被当作野孩子赶了出去。恩萧家对教育不是很看重,再加上凯瑟琳和希斯克利夫一起玩闹,显得很没教养,林顿夫人就把凯瑟琳收拾干净,教她做个淑女。回来之后,她的气质和性格都大变样,而希斯克利夫颇为不满,他感到自己被嫌弃了。这应该就是他们矛盾的开端。

其实从这里就能看出,凯瑟琳和希斯克利夫的关系之所以无法进行下去,很大程度上是受到了外界的规训。毕竟,凯瑟琳真的字面意义上地被“规训”了一番。林顿夫妇就是一个代表,他们象征着一套普遍的价值观,而这样的价值观是不允许凯瑟琳这样的小姐和希斯克利夫这样的野孩子在一起的。

凯瑟琳在要谈婚论嫁的时候也意识到了这一点,选择了和埃德格·林顿结婚,门当户对。同意结婚之后,凯瑟琳还和管家迪恩太太讨论过此事。从她的言语中可以发现,凯瑟琳最爱的是希斯克利夫:

我爱他,不是因为他好看,而是因为他比我更像我自己。

然而凯瑟琳不能做自己,而且她的自我意识也没有像现代人那样强烈到不做自己就活不下去,尽管有很多迟疑,她认为自己嫁给林顿是合理的。凯瑟琳的动机是我认为最值得品味的,凯瑟琳还说她自己就是希斯克利夫,她显然认可希斯克利夫是他的灵魂伴侣,但她非常清醒地做出了不和自己的灵魂伴侣结婚的决定,而且,她似乎并没有感到十分痛苦。

这对我而言难以理解,兴许是因为我和凯瑟琳这一人物在意识形态上的区别吧。

后来,希斯克利夫离开了啸风山庄,与凯瑟琳分道扬镳,也与恩萧家分道扬镳。回来之后,他也像凯瑟琳从林顿家回来时一样大变样,成了个成功人士,还赚了不少钱。此时凯瑟琳已经嫁入鸫翔庄园了,而希斯克利夫则向仇人辛德里在啸风山庄租了一间房。辛德里还是恨希斯克利夫,但是他更爱钱,所以收了这个房客。

此时,希斯克利夫的报复计划就正式开始了。

凯瑟琳的动机真的让我捉摸不透,她在希斯克利夫回来之后非常激动,一定要让家人与情敌来往。希斯克利夫并不打算追回凯瑟琳,他拐走了埃德格的妹妹伊莎贝拉·林顿——这应该是希斯克利夫复仇计划的开端,也是他非道德行为的开端。伊莎贝拉当时是真的被希斯克利夫的花言巧语迷惑,背着哥哥和他私奔了。

希斯克利夫当然不爱伊莎贝拉,根本不关心这个妻子。伊莎贝拉到了啸风山庄之后,连个换衣服和睡觉的地方都没有,因为主人辛德里不顾家事,山庄里已经没有几个干活的仆人了,希斯克利夫更是对伊莎贝拉毫不过问。最后她带着自己和希斯克利夫剩下的儿子,逃到了城里去住。哥哥已经不想要私奔的妹妹回家,希斯克利夫也不去找她,是她一人把林顿·希斯克利夫抚养长大。

在此期间,凯瑟琳也因为希斯克利夫的事情被搞得精神失常,得了怪病,生下女儿没多久就去世了。女儿也叫凯瑟琳,一般以小名凯茜称呼。凯瑟琳的死对希斯克利夫冲击很大,他在凯瑟琳死前的几天还在鸫翔庄园的地界躲藏,想要找机会接近凯瑟琳。不过他的注意力很快又被复仇之心转移了。

一直在城里和丈夫希斯克利夫分居的伊莎贝拉病逝,埃德格林顿本想把妹妹的孩子带回来抚养,但他当然无法和希斯克利夫这个“正当”的父亲争夺抚养权。继哈里顿之后,希斯克利夫又要残害另一个无辜的孩子了。

凯茜与林顿

接下来就是第二代的故事了。小林顿被接到鸫翔庄园暂住的时候,凯茜很喜欢这个表弟。林顿体弱多病,一直觉得不太舒服,可刚到没多久,与表姐才建立起感情,就又要被拉着去啸风山庄和希斯克利夫一起住。啸风山庄的环境和仆人的态度,他的母亲伊莎贝拉已经见识过了。总之,他过得并不好。

希斯克利夫并不想借林顿报仇。他教坏哈里顿是因为憎恶辛德里,他说,一想到辛德里的儿子比起喜欢父亲更喜欢自己,他就觉得非常舒畅。他对伊莎贝拉并没有多大的怨恨,毕竟伊莎贝拉只是他向埃德格(也就是抢走了凯瑟琳的男人)报仇下的一步棋,拐走他妹妹,让林顿一家蒙羞,就已经够了。他留下林顿,是因为埃德格也病弱,时日无多,他死后,应当由伊莎贝拉继承遗产,而伊莎贝拉也死了,所以应当由林顿继承遗产。他只要保证林顿活得比埃德格长,就能拿到遗产。

事实上他也的确做到了。辛德里死了,哈里顿忠诚于希斯克利夫,啸风山庄已经在他的掌控之下。接着他又耗死了埃德格,林顿家的财产也落入他手。这附近最大的两户人家,如今都归希斯克利夫所有了。这才有了本书第一章,洛克伍德先生从希斯克利夫那里租下鸫翔庄园的情节。

林顿死前,与凯茜来往密切,因为他们已经在短暂的相处中喜欢上了对方(是的…… 他们是表姐弟…… 凯茜是埃德格·林顿的女儿,林顿是伊莎贝拉·林顿的儿子…… 这才是本作的最大道德污点吧!)。希斯克利夫不允许林顿出门,埃德格也不允许凯茜靠近啸风山庄,因为担心遇到希斯克利夫这个灾星。

Well, it wasn’t sexy if it wasn’t forbidden…

总之,凯茜非常聪明地用书贿赂马夫,让他帮忙送信,他们两个就这么一直通信。迪恩太太发现那些情书之后,威胁要告诉她父亲,这才阻止了他们。但我说实话,这也只是让凯茜更想和林顿搞在一起了。后来迪恩太太卧病在床,凯茜就每天晚上骑马去啸风山庄找林顿。

希斯克利夫为什么不阻止这两个人呢?其实他反而在撮合这两个人,因为林顿和凯茜结婚对他有好处。埃德格的女儿若是嫁到啸风山庄来,一方面能激怒埃德格,另一方面他也更容易拿到林顿家的遗产。

也正是他的撮合,让凯茜和林顿的关系变得非常扭曲。林顿本身体弱多病,严重的时候甚至连走动都非常痛苦,再加上没有受到好的教育,也难怪他性格很不好。林顿在病重的时候,依然想要凯茜到啸风山庄来陪他,但两人陪伴的过程中,林顿什么都不想做,因为凯茜想做的事情对他来说都太累了,林顿又常常耍脾气,他们的相处其实相当不愉快。

但希斯克利夫不能容许两人不和,他在私下对林顿又打又骂,折磨这个本身就被病痛困扰的孩子,要他在凯茜面前表现好点。有好几次,林顿和凯茜见面时,明明因为身体不好不想做任何事情,连话都不想说,嫌凯茜和一同前往的迪恩太太太吵,却还是执拗地不要两个人走,因为希斯克利夫在远处看着,要是没把凯茜哄好,他就会被收拾。

再后来,希斯克利夫用林顿把凯茜和迪恩太太引诱进了啸风山庄大门,然后把二人软禁了起来。迪恩太太被关起来五天之久,在此期间,希斯克利夫已经逼着凯茜和林顿成婚了。

被放出来之后,林顿对迪恩太太说的话简直令我后背发凉:

“你们不放她走?你这小笨蛋!”我叫起来,“立刻跟我2说她在哪一件,否则我让你哭出来。

“要是你想去找她,爸爸才会让你哭出来呢。”他3说,“爸爸说,我不应该对凯瑟琳心软:她是我的妻子,她想离开我是不对的。爸爸说她恨我,希望我死掉,这样我的钱就会变成她的;可是她不应该拥有我的钱,她也不应该回家!她永远拿不到我的钱!无轮她怎么哭,哭到生病也一样!”

说完他又继续吃糖,闭上眼睛,好像他快睡着了。

林顿是坏人吗?他说话的语气和方式的确令人气恼,但实际上他也是受害者,是个可怜的孩子,失去了母亲,而父亲被复仇冲昏头脑,不干人事。疾病和精神的双重折磨让一个人的人生就这样被毁掉了。不过更让我感到发毛的是,有人能如此理直气壮地说出这样邪恶且毫无逻辑的话,而我们竟然无法谴责他。

一对冤魂

希斯克利夫的死很蹊跷。故事发生在最后的一两章,此时房客洛克伍德已经离开接近半年,再次返回鸫翔庄园时发现迪恩太太4已经不在,便到啸风山庄寻找。他发现啸风山庄比以前看起来怡人不少,这命途多舛的一群人的生活也有所提升。走近厨房见到迪恩太太,他才得知希斯克利夫已经死了。

于是迪恩太太继续给洛克伍德讲故事。林顿病死后,凯茜和哈里顿慢慢地走近了(凯茜是有什么奇怪的情节吗?哈里顿也是你表哥啊!凯茜是凯瑟琳·恩萧的女儿,哈里顿是辛德里·恩萧的儿子!)。抛去道德不谈的话,这一对其实还挺可爱的,比凯茜和林顿的安坏关系(大概可以这么说吧……)要好太多。

不知道为什么,哈里顿在后面几章的形象其实很戳我 XP还挺可爱的。在此之前凯茜和林顿一直嘲笑他没文化,不识字,是个文盲。尤其是林顿,常常在凯茜面前开哈里顿的玩笑,讲话很过分。哈里顿其实是想读书的,但被凯茜嘲讽,气得一个劲儿地骂人,竟然还直接把书烧了。后来在迪恩太太的教育下,凯茜才改变了行为。她其实没有恶意,只是有些娇生惯养,不习惯和没受过教育的人讲话。后来这两个人就开始了非常青春浪漫的校园式恋爱,凯茜教哈里顿识字读书,哈里顿也听得很认真。

嗯?你问我哈里顿可爱的点在哪里?呃呃,难道不觉得有些笨笨的男人想要变好,即害羞又好强地被逼急得涨红了脸的形象很可爱吗?让人很想要戏弄一下他呢。

与此同时,希斯克利夫已经不管这两个人了。他们在不在一起,对他来说都不重要。此时的他仍然身强体壮,但精神已经失常了,常常在幻觉里看到凯瑟琳。他去世的前几天,感到莫名其妙的高兴和兴奋,晚上不睡觉,出门走路,白天才回来,谁也劝不了他。

离世后,有小孩说在路上看到希斯克利夫,他不敢过去。这一描述暗示希斯克利夫的亡魂还留在附近,结合洛克伍德先生刚到啸风山庄时梦到的凯瑟琳的冤魂,可以想象这两个人终于以鬼魂的形式重聚了。他们的爱情并不被活人的世界允许,直到死后才能如愿。这或许也是为什么希斯克利夫会对死亡的临近感到激动吧。

叙述方式

我并不喜欢研究叙事策略和形式,但这部经典作品的叙述方式的确有很鲜明的特色,我这个门外汉也能读出些门道来。

首先是叙述者的设置,以及叙述者本人的时间与故事时间的交织。本书可以当作是洛克伍德先生的日记,他记录了进入鸫翔庄园之后的见闻,一直到他最后一次回到鸫翔庄园。恩萧和林顿一家的故事,是洛克伍德先生在鸫翔庄园入住时,从迪恩太太口中听来的。从到庄园、听故事、离开庄园、再次返回又听故事,这就是洛克伍德先生本人的时间线,中间他还几次去啸风山庄拜访房东希斯克利夫先生,每次都有不同的见闻,也与故事本身形成呼应。

迪恩太太口中的故事(以及亲自拜访时的见闻侧面反映出的故事)本身也有自己的一条时间线。洛克伍德的主观体验,和恩萧林顿家发生过的客观事实,以日记和口述的形式交织在了一起,是相当有趣的阅读体验。如何有趣,大概要亲自读过才能体会。

其次是类似戏剧的结构。这条我是从我读的译本附上的作品解读里读来的,我自己对戏剧结构倒是没有什么认识,不过可以看出,《啸风山庄》很明显地被分成了上下两幕,甚至还有幕间休息。第一幕是凯瑟琳与希斯克利夫的爱恨情仇,是第一代的故事。第一幕结束之后,洛克伍德还去啸风山庄拜访,之后才回来继续听故事,这便是幕间休息。第二代的故事自然就是第二幕了,以凯茜和林顿的关系为主,以希斯克利夫的死和凯茜与哈里顿的关系收尾。

另外,我也很难不被迪恩太太这个小角色打动。可能是被她对凯瑟琳、凯茜和两家人的忠心打动,也可能是被她的正义感和是非观念打动,而且整个故事几乎都是从她的口中说出,我想很多读者都会对这个讲故事的人产生好感。这种叙事方式除了形式新奇,结构精巧,还能让读者爱上故事里的角色,怎么不好呢?

本来说不纠结故事情节的,结果还是忍不住写了这么多。时间已经不早了,那就先写到这里吧。


  1. 参见: 简·爱 - Wikipedia  ↩︎

  2. 这里的「我」是迪恩太太。 ↩︎

  3. 这里的「他」是林顿·希斯克利夫。 ↩︎

  4. 洛克伍德先生入住鸫翔庄园时,迪恩太太还在那里做管家。所有关于恩萧和林顿两家的故事,都是迪恩太太口述给洛克伍德听的。 ↩︎

What’s next for the indie web?

I have been blogging in English for some time, but this is my first time participating in an indie web conversation. So I think I should introduce myself first.

I’m Eltrac. I’m mainly a web developer but I like all kinds of thing about programming. I code in Go, Clojure and Lua, and I explore new tech all the time. I usually blog more than three times a week, but most of my posts are written in Chinese. I recently became an active member of Codeberg e.V. and have been working on my own FOSS project weepinbell for a while. It’s a new Webmention receiver written in Clojure.

In this post, I will talk about why I developed weepinbell, how I designed its architecture, what I think of the IndieWeb movement and many things.

Why weepinbell?

I wrote to Brennan recently and he was really nice to mention weepinbell on his blog . In that email, I talked about how I set a new goal for weepinbell (i.e. an alternative to webmention.io) because of Aaron Parecki rewriting webmention.io with Claude. Later, in Aaron’s response to Brennan’s new post , he mentioned weepinbell as “a direct response to my rewrite”.

I would like to make things clear. I didn’t start developing weepinbell because of Aaron’s rewrite. I started early in this May to learn Clojure. I’ve been blogging (in Chinese) for years and of course I love the concept of IndieWeb. Naturally, my practice project for learning a new language involves IndieWeb technologies.

The motive is that I want to get my hands dirty with the Webmention standard. I read through the W3C specification document and started putting things in parentheses. You can still find snippets from that document in my code as comments. I bascially code against the specification. It was a fun experience for me.

 (if-let [error-msg (check-request source target allowlist)]
 ;; respond if request verification failed
 (bad-request {:status 400
 :message error-msg})
 ;; proceed if request is ok
 (do
 ;; The receiver SHOULD check that target is a valid
 ;; resource for which it can accept Webmentions.
 ;; This check SHOULD happen synchronously to reject
 ;; invalid Webmentions before more in-depth verification begins.
 ;;
 ;; Webmention verification SHOULD be handled asynchronously
 ;; to prevent DoS (Denial of Service) attacks.
 (put! wmc new-wm)
 ;; respond with 201 when Webmention passed checks and
 ;; was sent into queue, include a Location header
 (let [wm-id (digest (str source target))
 wm-url (str (:base-url config) "/api/mention/" wm-id)
 response {:status 201
 :message "Webmention is accepted and pending for verification."
 :url wm-url}]
 (created wm-url response))))))

This snippet is from receiver.clj .

After the initial quick and rough implementation, I stopped working on weepinbell for a few months. And it had been receiving Webmentions for my blog during that time. Everything worked and I was content. It was bascially a personal tool.

Then the webmention.io rewrite came to my attention.

Why does it bother me? I don’t even use webmention.io any more. I see some of my friends seeking alternatives, and… there aren’t many to choose from! There is webmentiond by Horst Gutmann and some other implementations here and there. My friend Chlorine developed CircleAt in Rust. And I’m sure there are many more. But frankly, none of them truly count as “alternative to webmention.io”.

Don’t get me wrong. I think many of them are great for their purpose, i.e. small service one can self-host. However, they can be quite difficult for the non-tech indie web folks and those who simply do not own a server. They need a public instance.

Refactoring for scalability

I decided to continue development of weepinbell and make it “the next webmention.io”, at least that’s what I’m going for.

So I took a closer look at my code. They’re not that messy, well partitioned (for the most part) and maintainable. I can swap some of the parts easily because I used hook functions and vtables.1 The architecture is flexible enough, and the Lisp power also makes modifying software really easy.

The following part will be somewhat technical. Feel free to jump to the next section if you don’t want to read about system design. The bottom line is: weepinbell would be lightweight enough for people to self-host; it would also be scalable enough to support large traffic.

I’m a Go programmer by the living.2 And Clojure’s core.async library greatly resembles Go’s concurrey programming style, which means my skills of building scalable applications in Go translates.

Webmention is not big data. Storage is definitely not the bottleneck. In fact, up until a few commits ago , weepinbell does not even support any type of database. It unloaded everything in a single file and then loaded it back when needed. And it just… worked, for months.

Of course this is neither performant nor safe. If I want to build something reliable, I need a database. If you have taken a look at that commit I linked, you might notice that the business logic is untouched. All that’s added is a new storage implementation, a new config option, and a few lines in the main component (core.clj).

I’ll probably elaborate on architecture flexibility in another post. That’s something I’m really proud of. The gist is that using a new type of database and ORM is easy, and will be just as easy if I ever decided to redo the storage layer again.

;; all I need to make sure is that the new storage implementation
;; returns a valid storage vtable, like this:
(defn use-store [db-file]
 (let [ds (make-datasource db-file)]
 (create-tables ds)
 {:append (partial insert-webmention ds)
 :update (partial update-webmention ds)
 :delete (partial delete-webmention ds)
 :get (partial get-webmention ds)
 :get-by-domain (partial get-webmentions-by-domain ds)}))

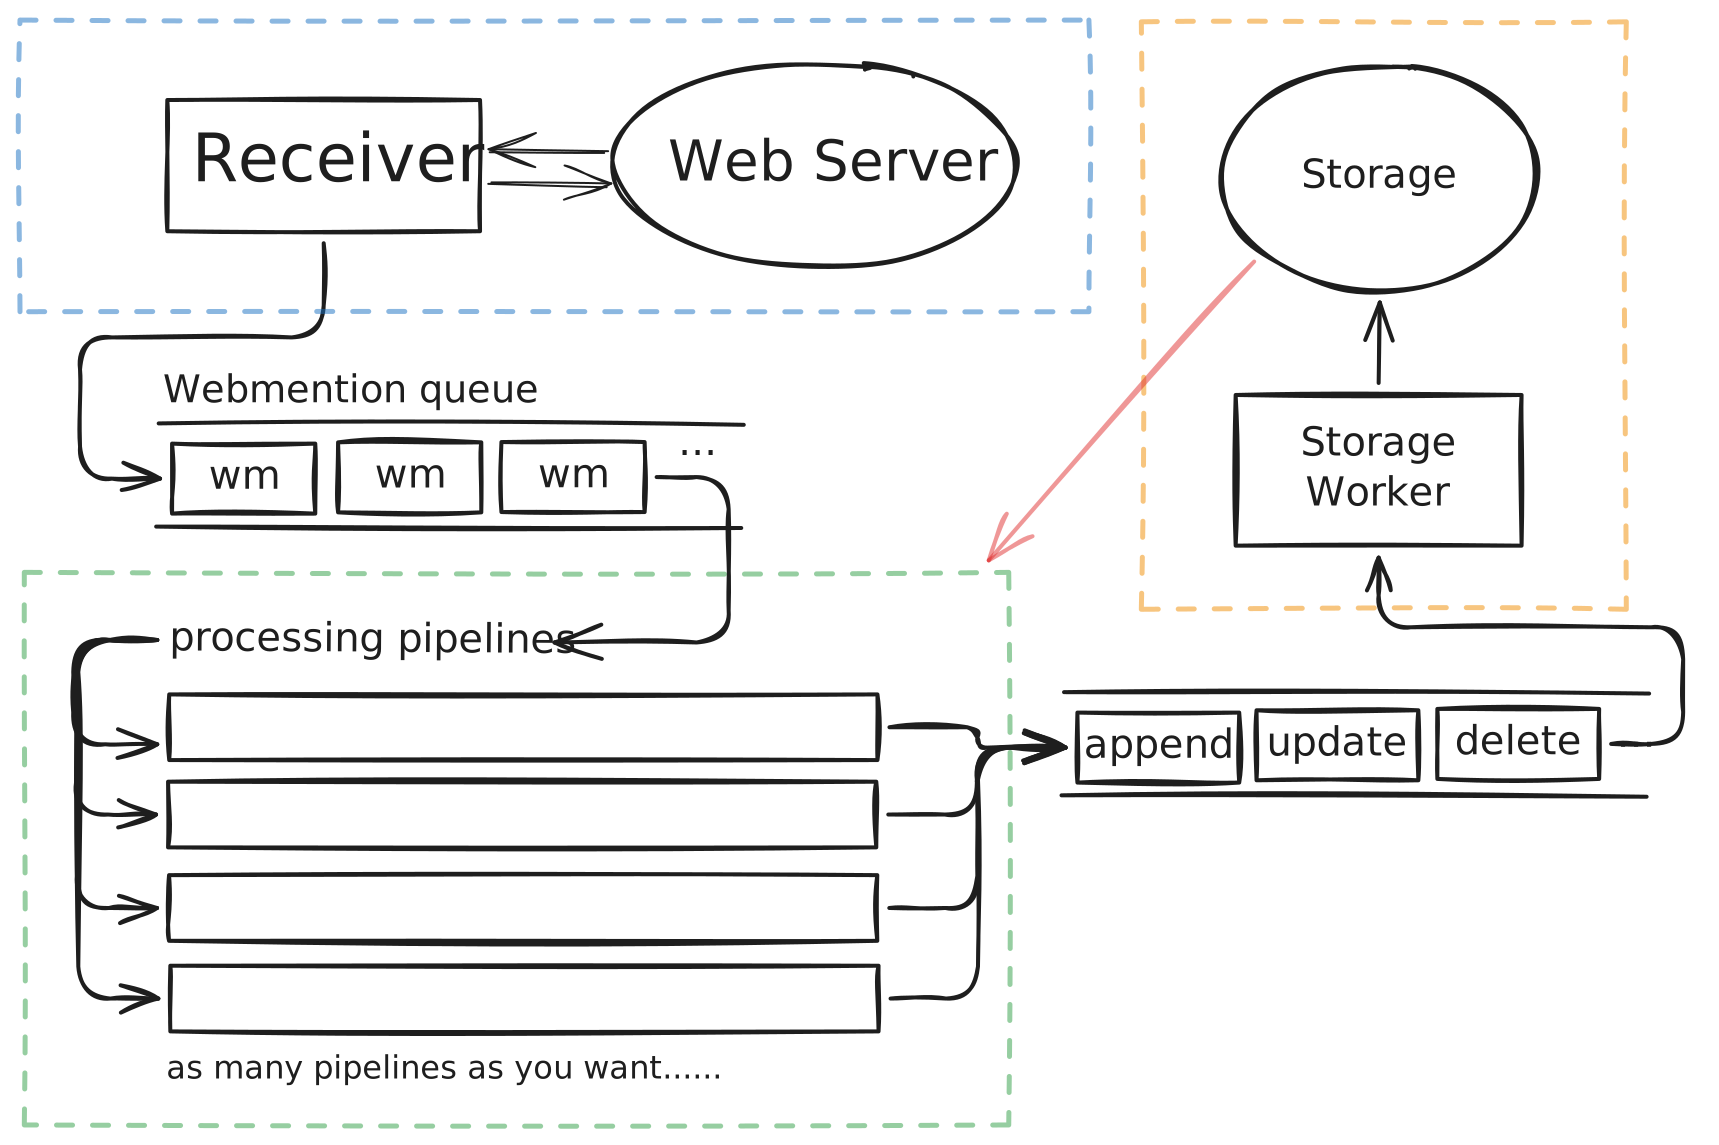
Beside a new SQLite implementation, I added a storage worker that handles I/O asynchronously. So when processing a new webmention, the processor won’t have to wait for DB transaction (or appending to a file; it does not care about what’s going on underneath) to end. It simply delegates to the storage worker and keeps processing the next webmention.

The processor delegates by putting an operation object into a channel. It’s similar to what I already have for receiver. When a new webmention request is sent to the web server, receiver does some basic checks (e.g. does source and target look like real URLs?) and then put the request into the webmention queue. A processor will pick it up and make sure source has truly mentioned target, parse microformats, wrap data into a valid record, and hand it over to storage worker.

Reading from a channel is thread-safe. And since I/O is handled internally by storage worker, it can also be thread-safe, without the need for a mutex lock. So we can add as many processors as we want to handle webmentions concurrently.

The overall architecture looks like this:

Architecture of the receiver part of weepinbell, drawn using Excalidraw

That’s horizontal scaling. For self-hosters, simply set pipeline-concurrency to 1, and there will be only one processor handling webmentions, using a reasonable amount of RAM and CPU.

For large groups or someone who wants to host a public instance, change a number in config and you’re good to go.

All of that is compiled to a single .jar.3

The microformats nightmare

Before I move on to a non-tech topic, there’s one thing I have to complain: Using microformats markup is easy. Parsing it is really not.

Here is an example snippet from microformats.io .

<div class="h-card">
 <a class="p-name u-url" href="http://blog.lizardwrangler.com/">Mitchell Baker</a>
 (<a class="p-org h-card" href="http://mozilla.org/">Mozilla Foundation</a>)
</div>

It’s just regular HTML with standardized class names like h-card and p-name. It’s easy to add a few classes to your HTML. However, it’s still hard to parse structural data from HTML with just a few more classes.

Good thing there are already some parsers available… right?

Production ready parsers are available for: Go, Node, PHP, Python, Ruby.

Right… I’m using Clojure…

Clojure can use Java code, since it runs on top of it. I found mf2j , an “In-development Java parser for microformats2”. It hasn’t been updated since… 10 years ago.

There is a Clojure implementation . It’s archived, with its last update committed 11 years ago.

Do I implement a new one myself? Do I pick up where they left off? How do I make sure I don’t burn out and abandon it as well? After all, Clojure is a niche language and IndieWeb is also kind of niche. I can’t imagine there being another Clojurist building something that relies on microformats. At least, I don’t know anyone like that.

I briefly considered running a micro-service that wraps the Go parser, and weepinbell can talk to this service using RESTful API or gRPC. But it feels heavy and everything just won’t fit in a single .jar.

So how can Clojure run programs written in a non-JVM language? What else runs on JVM? Scala, Groovy… Wait, will WebAssembly work?

Yes! WebAssembly runs on JVM. There is a native JVM WebAssembly runtime called chicory .

I spent an afternoon studying Extism and chirocy. Then I wrote a tiny little Go wrapper of Will Norris’ parser library .

package main

import (
	"bytes"

	"github.com/extism/go-pdk"
	"willnorris.com/go/microformats"
)

//go:wasmexport parse
func parse() int32 {
	input := pdk.Input()
	r := bytes.NewReader(input)
	data := microformats.Parse(r, nil)

	pdk.OutputJSON(data)
	return 0
}

Then I compiled it to .wasm using tinygo compiler, bundled the .wasm inside .jar, and called the Extism plugin from Clojure using chicory. Voilà! Here’s mf2clj , a Clojure wrapper of WebAssembly compiled from a Go wrapper of an existing microformats parser.

By the way, I made a little logo just for fun.

A combination of Clojure logo and the microformats logo

You use it just like a normal library in Clojure. And it’s surprisingly fast.

(require '[mf2clj.core :as mf2clj])
(mf2clj/parse html-string)

More surprisingly, bundling a .wasm binary and the WebAssembly runtime inside the .jar is not as heavy as I thougt it would be. The .jar only grew 2 MB in size. Am I really running Java?

Nevertheless, the nightmare isn’t over yet. In the begining, I settled for the incomplete mf2j library and used it for a while. At that time, I called the JSON output “data structure from Hell”. I still do —— Everything is an array! Everything is deep inside something’s properties or children! Nothing is deterministic! Every website’s format is different!

{
 "items": [{
 "type": ["h-card"],
 "properties": {
 "url": ["http://blog.lizardwrangler.com/"],
 "name": ["Mitchell Baker"],
 "org": [{
 "value": "Mozilla Foundation",
 "type": ["h-card"],
 "properties": {
 "name": ["Mozilla Foundation"],
 "url": ["http://mozilla.org/"]
 }
 }]
 }
 }],
 "rels": {},
 "rel-urls": {}
}

In the end, I had to write a smaller parser to parse output a the original parser. I called this feature microformats reduction. I remember webmention.io having something similar.

"microformats": {
 "author": {
 "name": "Mitchell Baker",
 "url": "http://blog.lizardwrangler.com/",
 "photo": "https://blog.lizardwrangler.com/photo.png"
 },
 "type": "mention",
 "published": "2026-07-25T00:00:00-07:00",
 "content": {
 "html": "..."
 "text": "..."
 }
}

If something does not exists, it’ll just be null. The format is not final yet, I will make some adjustments. This can be turned off by ?microformats=raw when querying webmentions.

Also, I think more than half of the bugs I found in weepinbell have something to do with microformats-related features. Maybe we should switch to Open Graph and JSON-LD, folks?

Anyway, I’m just glad it’s finally working.

Slowing down

At this point, I’ve almost finished everything I have planned for the v1.0.0 release: a proper database, horizontal scalability, up-to-date microformats parser. As for hosting a public instance, that’ll involve authenticating users and making a dashboard for them to manage webmentions. That would be a separate project.

I plan to develop a service that sits in front of weepinbell, handling logging in and stuffs. I mentioned the idea in the project’s PHILOSOPHY.md .

I want to keep the core of weepinbell minimal. Those who want to be their own sysadmins don’t have to care about authentication. They don’t even need a frontend. They only need to self-host one .jar and use API to query webmentions, use RSS to receive notifications and use webhook to automate stuff. These are the built-ins.

A platform like webmention.io needs more than that. If I want to keep weepinbell “for both individuals and large groups”, I have to separate things. Also, this makes everything modular and swappable, a pretty good architecture decision.

My writing to Brennan was an attempt to get more Clojure developers on the team. Well, that didn’t go well. For the new platform, which will be named Ringabell4, I want to use more mainstream stack, probably Go, so that it’s easier for people to get involved.

For now, I’m still working on weepinbell’s test suite. The current test coverage is more than 83%, but there are still some edge cases that haven’t been covered by tests. I had to test a lot of paths by hand. Also it’ll take some time for the new SQLite implementation to be stable.

I don’t think we need to or should move fast when it comes to developing reliable software, with or without LLMs.

Independence, and now decentralization

In reply to Brennan’s recent question, “What do we do now?” , I think it’s finanlly time to get more decentralized.

Decentralization is never about moving away from the corporate web (that’s independence). It’s about not relying on a single point , no matter what the point is and who it involves.

I agree with Brennan on not conflating IndieWeb and the lower-case indie web. The IndieWeb camp is a nice community and a great introduction to the indie web. But I think we should form more indie web communities other than the IndieWeb camp.

omg.lol is an example. It’s a fun web community by Neatnik . They provide infrastructure like a simple profile page, Fediverse instance and email forwarding. Brennan is also building folk.zone , which hosts a fork of webmention.io and many more.

Those two may not be exactly alternatives to the IndieWeb camp, but they can be. And there can be more for people to choose from.

Tech folks can self-host their own infrastructure if they want. For the non-tech folks, there should be more alternatives to what the IndieWeb camp has to offer. Poeple who are capable can host public services and take a small community.

After all, communities are what brings the indie web together. We can and should build more communities (this is probably more like polycentricity rather than decentralization). We can have the LispyWeb for lisp programmers, ArtsyWeb for artists, and Indie Indie Literature Club!5 for book lovers. Those are just some random names I came up with.

Perhaps the upcoming Ringabell might be the next cozy small community. Who knows? To everyone who’s nice enough to finish reading this, I hope we can all find our people.


  1. A vtable in Clojure is basically a hashmap whose values are functions. It’s a technique mentioned in one of Uncle Bob’s books, Functional Design. ↩︎

  2. Actually I’m at the very begining of my career. Don’t think of me as an expert of anything. XD ↩︎

  3. Clojure runs on JVM, so it compiles to JVM bytecode, just like Java. ↩︎

  4. Meaning “ring a bell”. ↩︎

  5. The referrence is a galgame called “ Doki Doki Literature Club ”. :3 ↩︎

Coffee Break Clojure, Transducer

在第三期《 只用圆括号怎么够? 》里,我讲到了 reduce。

先来简单复习一下:reduce 最少接收两个参数,形如 (reduce f coll),其中 f 是接收两个参数的函数,形如 (f x y);reduce 遍历 coll 中的每个元素,先对前两个元素求 (f a1 a2),1然后求 (f (f a1 a2) a3),以此类推。

(f x y) 这种函数叫作归约函数(reducing function)。

归约、Fold、高阶函数

之前我们用作示例的代码如下:

(def numbers '(1 43 231 23 99))

(reduce + numbers)
;; => 397

+ 可以视作归约函数,因为他可以这样调用:(+ x y)。当我们对上述代码进行求值时,主要执行了以下步骤:

  1. (+ 1 43) 得到 44
  2. (+ 44 231) 得到 275
  3. (+ 275 23) 得到 298
  4. (+ 298 99) 得到 397

使用 + 作为归约函数,对 numbers 进行归约(reduce),就实现了累加。

在函数式编程里,归约(reduce)也叫作累积(accumulate)、聚集(aggregate)、压缩(compress)和注入(inject),不过更常见的名字是折叠(fold)。折叠分左折叠(foldl)和右折叠(foldr)。

还记得第三篇讲过的 Cons 和 Lisp 的列表构造方式吗?Fold 的结构就像是函数版本的 Cons。

(reduce f [1 2 3 4 5])
;; 等价于
(f (f (f (f 1 2) 3) 4) 5)
(list 1 2 3 4 5)
;; 等价于
(cons 1 (cons 2 (cons 3 (cons 4 (cons 5 nil)))))

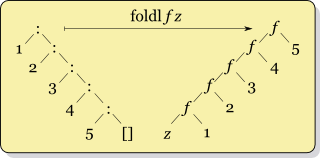
Clojure 的 reduce 默认是左折叠,即 foldl:

左折叠示意图;图源: 维基百科

要在 Clojure 里实现右折叠,只能把待操作的列表倒序:

(reduce f (reverse [1 2 3 4 5]))
;; 等价于
(f (f (f (f 5 4) 3) 2) 1) ; 实际上还是左折叠
;; 如果 f 和 + 一样满足交换律,就等价于
(f 1 (f 2 (f 3 (f 4 5))))) ; 等价于右折叠

折叠中的 f 本身也可以是折叠。还记得 into 吗?

(into [1 2 3] [4 5])
;; => [1 2 3 4 5]

;; 等价于
(reduce conj [1 2 3] [4 5]) ;; 这里的 reduce 以 [1 2 3] 为初始值
 ;; 如果没有初始值,就会用第一个元素做初始值
;; 等价于
(conj (conj (conj [1 2 3]) 4) 5)

如果要打平一个向量,比如把 [[1] [2 3] [4 5]] 变成 [1 2 3 4 5],就可以用 into 作为归约函数(reducing function),也就是把 (reduce conj ...) 作为 reduce 的 f。

(reduce into [[1] [2 3] [4 5]])
;; => [1 2 3 4 5]

;; 等价于
(reduce #(reduce conj %1 %2) [[1] [2 3] [4 5]])
;; 等价于
(reduce conj (reduce conj [1] [2 3]) [4 5])
;; 等价于
(conj (conj (conj (conj [1] 2) 3) 4) 5)

在 Clojure 中,能够被放在 reduce 里使用的函数就叫作归约函数(reducing function)。这个概念与函数式编程和 Lambda 演算的高阶函数(Higher-order function)有关,据说微积分中的导数也算一种高阶函数,但我这篇文章不是讲数学的(我也不会数学),所以就点到为止。

改造归约函数

总结一下,归约函数就是这样的一类函数:

(f result input) -> new result

这样的函数可以相互嵌套使用,不过一般传给 reduce 用。

接下来要引入一种新的函数,我没有找到中文译名,暂且称作变约函数(transducer)。它长这样:

(t (f result input)) -> (new-f result input)

Transducer 接收一个归约函数,返回新的归约函数。

返回函数的函数可能有些抽象,但是在 Clojure 中很常见。我举几个例子解释 Transducer 的用法。

假设我们要对向量自增,然后再累加,就要这样写:

;; 下面这个函数先是自增 [1 2 3 4] 得到 [2 3 4 5]
;; 然后再对 [2 3 4 5] 进行累加
(reduce + 0 (map inc [1 2 3 4]))
;; => 14

能不能让 + 这个归约函数,在把之前的结果和下一个元素累加起来之前,先给要累加的元素 + 1?也就是说,我们不用遍历一遍列表,生成新的、自增后的列表,然后再累加这个列表,而是在累加的过程中就把自增的操作也做了。

我们可以这样写:

;; 下面这个函数用 (map inc) 这个 Transducer
;; 把 + 这个归约函数,转换成了新的归约函数
;; 这个新的归约函数的作用是:先给单个元素 +1,然后再累加
(reduce ((map inc) +) 0 [1 2 3 4])
;; => 14

这里我们看到了 Clojure 1.7 引入的 map 的新用法。一般而言,(map f coll) 的作用是把 f 作用在 coll 中的每一个元素上,然后生成新的元素。

而 (map inc) 则是生成了一个 Transducer,我们把 + 作为这个 Transducer 的参数传入,得到了新的归约函数。也就是说,我们将 (map inc) 和 + 组合,构造了新的数据转换算法。 对集合中的元素 inc,然后再折叠 + 实现累加。

这种转换与具体类型无关,与惰性无关,与执行顺序也无关,只是纯粹的算法。非常便于复用。

将具体类型与转换算法解耦

Clojure 的哲学是简洁,这点并不只是体现在语法(syntax)上,还体现在语义(semantics)和语言的设计上。Rich Hickey 在《 Simple Made Easy 》里讲到,简单(simple)的东西就是不和其他东西交织(complect)在一起的东西。

Java 类不简单,因为它既是命名空间,又是数据结构,还定义了数据上的操作——类把三个东西交织在了一起。反观 Clojure,命名空间是单独的概念。

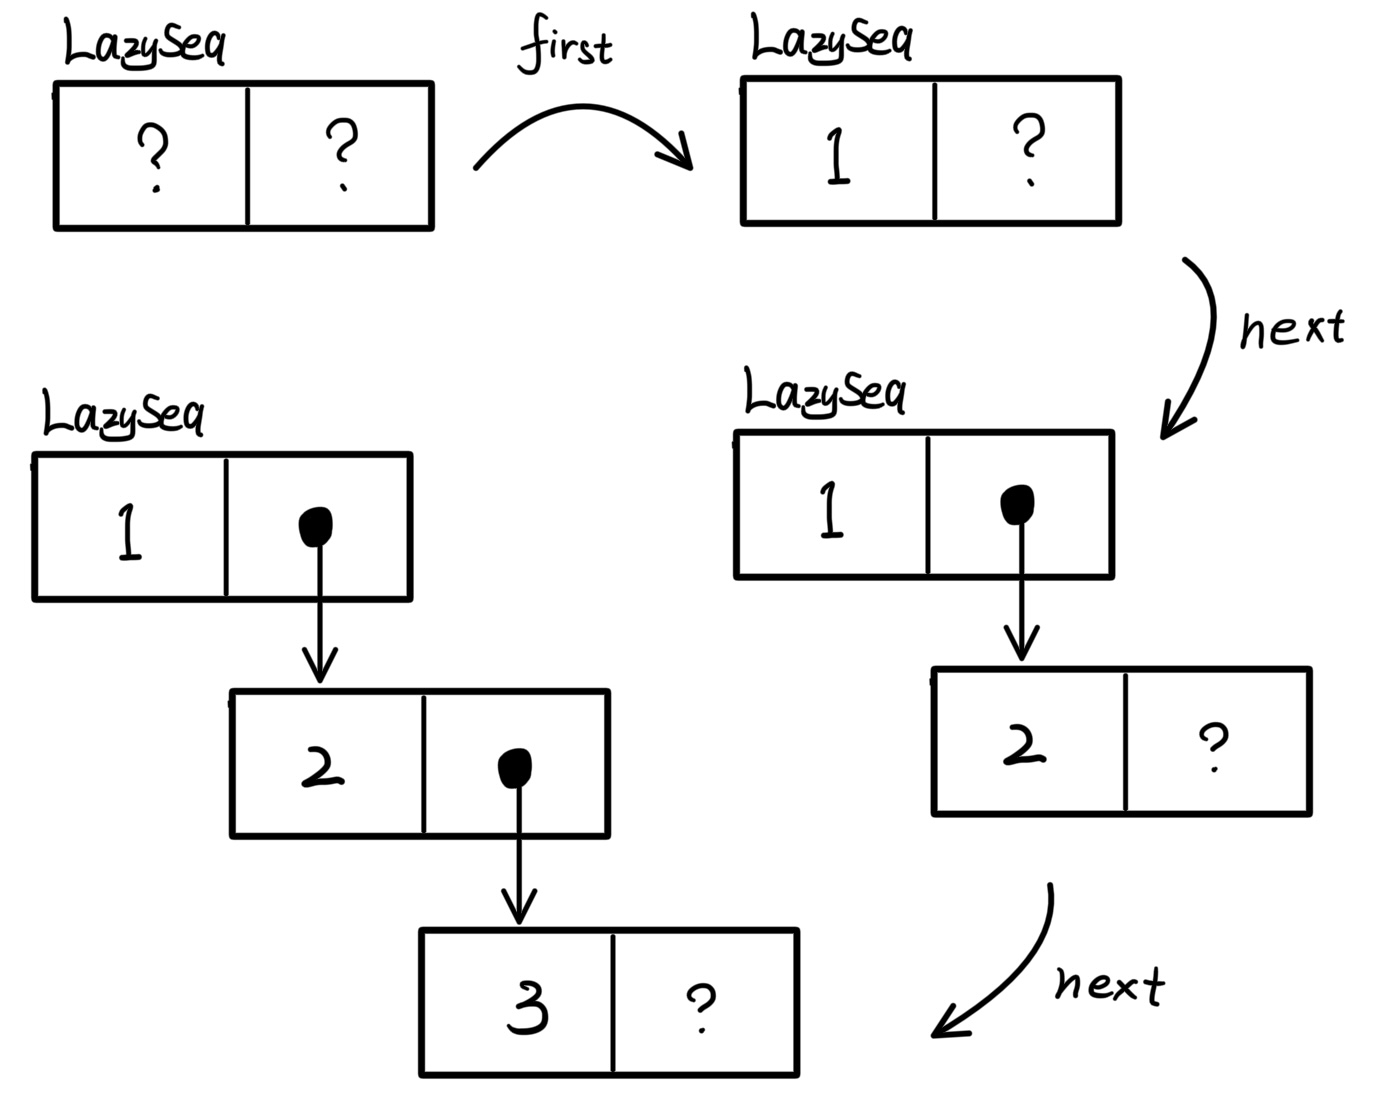
标照 Rich 本人对简单的定义,标准库里的 map、filter、reduce 等操作序列的函数,都不够简单,因为他们不仅涉及做什么操作(what to do),还涉及了怎么做(how to do it)——预设了惰性,预设了数据操作的顺序(序列都是从前往后线性遍历的),预设了数据的表示方式(返回的是序列)。

如果 map、filter、mapcat 等函数,能够与数据类型(序列)解耦呢?也就是说,如果 map 只定义做什么操作(what to do) ,把怎么做(how to do it)交给其他组件呢?

比方说,map 可以这样实现:

(defn map [f]
 (fn [f1]
 (fn [result input]
 (f1 result (f input)))))

这个 map 是构造 Transducer 的函数,它接收函数 f,返回了一个返回函数的函数。我们之前看到的 (map inc) 就返回了一个 Transducer。

这就是对做什么(what to do)的定义。

reduce 则定义了怎么做(how to do it),因为 reduce 是对序列的操作,而且是具有惰性的,返回值是惰性序列。所以把 reduce 的怎么做(惰性地、顺序地、当作序列执行左折叠)与 ((map inc) +) 的做什么(“元素自增后再累加”)组合,就得到了完整的数据操作。

如果不想要折叠呢?我能不能直接用 (map inc) 累加元素?

将 sequence(输入和输出数据为序列、惰性、顺序操作)与 (map inc)(“自增集合里所有的元素”)这些要素组合起来,才能得到完整的数据操作:“自增序列里所有的元素逐一自增,返回惰性序列。”

(sequence (map inc) [1 2 3])
;; => (2 3 4)

如果不想用序列和惰性序列,可以换成向量或者集合:

(into [] (map inc) [1 2 3])
;; => [2 3 4]

(into #{} (map inc) [1 2 3])
;; => #{4 3 2}

如果没有用 Transducer,我们就必须先把向量变成序列,然后再把序列变回向量。因为 map 和许多函数都只操作序列和惰性序列,和具体的数据类型耦合。

(map inc [1 2 3])
;; => (2 3 4) ; <- 这里得到的是序列,而非向量

(vec (map inc [1 2 3])) ; <- 必须手动转换成向量!
;; => [2 3 4]

(into [] (map inc) [1 2 3]) ; <- Transducer 不关心数据类型
;; => [2 3 4]

上一篇《 异步编程和并发控制 》提到的 channel 也可以接收 Transducer,携带 Transuder 的 channel 会对经过它的所有数据做变换。

(def growing-channel (chan 1 (map inc)))
;; => #'user/growing-channel
(put! growing-channel 1)
;; => true
(poll! growing-channel)
;; => 2

Transducer 的好处就是,由于他只定义了抽象的「做什么」,而不关系具体的「怎么做」,所以可以非常轻易地用在任何地方,不像 map 和 filter 只能作用于序列(或者要把向量、集等其他数据类型转换为序列)。

组合 Transducer

一般来说,要做 Clojure 里做一系列数据操作,会组合使用很多序列函数。

(->> [1 2 3 4 5 6 7 8]
 (filter odd?) ; 1. 过滤,只留奇数
 (map #(* 2 %)) ; 2. 全部乘 2
 (reduce +)) ; 3. 累加
;; => 32

有了 Transducer,我们可以把这一系列操作抽象出来,定义成一个独立的、可复用的操作。

(def double-odd-numbers
 (comp 
 (filter odd?)
 (map #(* 2 %))))

; 可以用来累加
(reduce (double-odd-numbers +) 0 [1 2 3 4 5 6 7 8])
;; => 32
; 等价于
(transduce double-odd-numbers + [1 2 3 4 5 6 7 8])
;; => 32

; 可以不加,返回集合
(into #{} double-odd-numbers [1 2 3 4 5 6 7 8])
;; => #{6 2 14 10}

; 如果你想,还能交给 channel
(def double-odd-chan (chan 1 double-odd-numbers))

comp 的作用是把函数组合起来。(comp f g) 就相当于 (f (g ...))。除了用来组合 Transducer,还可以组合普通的函数:

(filter #(not (zero? %)) [1 2 0 3 0 2 0])
;; => (1 2 3 2)

; 等价于
(filter (comp not zero?) [1 2 0 3 0 2 0])
;; => (1 2 3 2)

不妨做个小练习,定义一个 pipe 函数,作用是接收可变数量的函数2,将它们构造成类似 -> 箭头宏的流水线结构,但是不执行这个结构,而是返回函数。比如 (pipe f1 f2 f3) 就返回按顺序执行 f1、f2、f3 的函数,(pipe f1 f2 f3) 相当于 (f3 (f2 (f1 data)))。

参考答案
(defn pipe [& functions]
 (apply comp (reverse functions)))

或者:

(defn pipe [& functions]
 (fn [value]
 (reduce (fn [result f] (f result)) value functions)))

要注意 Transducer 和一般函数的区别。

(comp
 #(map (fn [x] (* 2 x)) %)
 #(filter odd?))
; comp 的结果是 (map fn (filter odd? ...)),很符合直觉
; 返回的函数用来直接操作序列

(comp
 (filter odd?)
 (map (fn [x] (* 2 x))))
; comp 的结果看似是反过来的 (filter odd? (map fn ...)),其实不然
; comp 并不是 -> 宏,而是函数,会先对参数求值
; filter 和 map 求值之后得到了 Transducer
; comp 是把两个 Transducer 组合起来了,而不是把 filter 和 map 组合起来
; 返回的函数用来和 reduce, into, sequence, chan 等一起使用

最后

这篇的内容可能略显抽象,因为涉及了很多对函数的操作,而不是对数据的操作。如果没理解也没有关系。Transducer 能让数据类型与算法解耦;能轻易地组合复用;给了 Clojure 程序员更多的控制权,所以能借助它来写出性能更好的代码——这些都是好处,但没有这些好处也照样能写 Clojure 代码。

那么,回见!


  1. 也可以指定初始值,(reduce f init coll) 会先求 (f init a1),再求 (f (f init a1) a2) ↩︎

  2. 用 & 表示参数数量可变,(fn [& args]) 中的 args 就是包含可变参数的序列。 ↩︎

Coffee Break Clojure, Async

上一篇 我提及了如何用 Ring 开发 HTTP 服务器,也提到 Ring 提供了同步 API 和异步 API。那么,什么是异步编程?为什么需要异步?在什么情况下需要让一个程序同时做很多事情?

同步、异步、并发和并行

同步(synchronization)的中文名字可能会让人误以为是多个实体同时进行操作,实际上同步的意思是指系统中所有事件都依照相同的顺序进行协调。可以用工厂流水线举例,假如流水线中一个工人需要等上一个工人交付一部分工作之后才能干活,整个流水线都要所有人一起干活才能转动起来,这个流水线就是同步的。反之,假如某些工作可以分开做,比如一部分人负责生产 A 零件,另一部分人负责生产 B 零件,两者互不干扰,而最终把 A 和 B 组装在一起的又是另一拨人,这个系统就是异步的(asynchronous)。

异步(asynchrony)和并发(concurrency)很容易搞混,并不是同一个概念。异步是指系统中各个事件的状态不同步,而并发通常是指多个线程(或类似线程的东西)同时做类似的操作。

以下分别是异步和并发的例子:

  1. 小明和小华准备去桌游店玩,小明负责去买饮料和零食,而小华先去桌游店占位置。他们的状态是不同步的,小华并不需要等到小明买完东西才能去桌游店。不过,小明和小华最终会在桌游店汇合,他们一起玩桌游时,就又回到了同步状态。

    异步通常是程序里的一小部分,如果系统中所有任务都是异步的,那这些任务大概就不应该放在同一个系统里了,因为状态之间没有同步的必要。

  2. 某推销团队在城市某片区招募了 100 名推销员,给他们派发相同的任务:向路人介绍产品,并尽可能获客。从整个推销计划的角度来看,这是个并发度为 100 的系统,增加并发度能够提高单位时间内的销售成绩,减少并发度效果则相反。也可以说推销员之间是异步的,但系统整体是同步的,销售成绩最后都会汇总到一个地方。

简单来说,异步是局部状态,对系统整体影响不大,而并发则事关整个系统的执行效率,是更宏观的概念。

从编程实践来看,并发往往是更大更复杂的系统才考虑的(比方说网络爬虫必然不能一次只爬一个网页),而异步则是较小的程序会采用的轻量方案(比方说网页渲染中加载某些资源时为了不阻碍主线程,所以要异步加载)。

至于并行(parallelism),这个概念经常在操作系统的语境里和并发做区分。并行是指程序同时运行在多个 CPU 核心上,是物理意义上的同时发生;并发是指 CPU 调度器时进程交替执行,由于交替速度非常快,所以即便是在单核机器上,也能造成程序在同时运行的假象。

脱离操作系统的语境,这种区分的意义就不大了。在编程的语境下,并行是指程序在同时进行的事实(开发者很少在乎程序究竟是在多核还是在单核机器上运行的,这对编写程序而言不重要),而并发则是组织程序的一种方式。

接下来就看看如何在 Clojure 里组织异步和并发。

面向未来编程

前文提到,异步是局部状态,系统最终还是要同步信息的。许多编程语言里的做法是,在当前线程(thread)里启动子线程,相关的线程都持有对同一块内存区域的引用,他们在这一块内存区域里读写数据。之前我提到,Clojure 是 函数式编程语言 ,不允许共享状态,那怎么办呢?

假设我们需要从某个 API 获取数据,但问题是网络状态不稳定,这个操作可能很费时间。与此同时,我们还要处理手头已有的数据。

;; 这里用到了 https://github.com/dakrone/clj-http
(require '[clj-http.client :as client])
(let [response (client/get "https://example.com")
 result1 (process-data (:body response))
 result2 (process-data some-data-we-already-have)]
 (merge result1 result2)))

上面这段代码会在求值 client/get 这个形式的时候被阻塞,直到收到 HTTP 响应体。假设 process-data 操作也要费时间,这个程序的效率就很低,因为在等待网络传输的时间里,程序本身什么都没做。

如果不能提前定义 result1 变量,然后再异步执行完 client/get 之后写入 result1 变量,主线程怎么拿到数据呢?

这时可以用到 future 和 deref。future 宏接收一系列表达式,然后立刻返回一个 ref(引用),在之后,我们可以用 deref 尝试获取 ref 指向的值。如果 ref 指向的值还不能获取,就阻塞调用 deref 的线程。

(require '[clj-http.client :as client])
(let [response (future (client/get "https://example.com"))
 result2 (process-data some-data-we-already-have)
 result1 (process-data (:body (deref response)))]
 (merge result1 result2)))

把 client/get 包裹在 future 宏里之后,我们立刻得到了 response,这个 response 并不是实际的 HTTP 响应,而是对未来能够获取到的数据的引用。

拿到这个引用之后,我们立刻处理手头已有的数据。等这些数据处理完成之后,尝试 deref(解引用)一开始拿到的引用,此时 HTTP 请求已经发出有一段时间了,我们有可能直接就能拿到数据,然后就可以开始处理了;如果没拿到,也只需要再等一会儿,比一开始就等着什么也不做强多了。

持有对未来可用数据的引用,和持有对某一块内存区域的“引用”,有什么区别呢?

可以发现上述程序没有状态变更,future 返回了一个值,deref 不过以 future 的返回值作为输入,返回了新的值,数据流很清晰,很函数式。此外,它还很优雅地把程序从异步状态恢复到了同步状态,不需要我们自己写同步逻辑。

以这个 Go 程序为反例:

package main

import (
	"fmt"
	"time"
)

func main() {
 // 定义一个变量用来存放数据
 result := ""
 // 异步执行函数,两秒后给 result 赋值为 "OK"
 go (func() {
 time.Sleep(2 * time.Second)
 result = "OK"
 })()
 // 轮询,直到 result 不是空字符串才退出循环
 for {
 if result != "" {
 fmt.Println(result)
 break
 }
 }
}

这段程序既要管理状态,又要轮询状态,非常难读。

Go 语言也有自己的异步编程范式,实际上不必这么写。之后我们就会看到 Go 的异步编程,因为 Clojure 也借鉴了 Go 语言。

其实我本来想用 JavaScript 写,但我在浏览器里执行的时候,我的页面竟然卡死了。后来我才知道浏览器的 JS 运行时是单线程的,用于轮询的无限循环把主线程卡死了,JS 根本没时间管子线程,于是赋值语句就一直没执行。JavaScript 也有类似于 future 的 async 关键词,async 函数会返回 Promise,类似于 ref,而 deref 对应的是 await,详见 MDN: async function 。

如果你熟悉 JavaScript 的 async 和 await,那 Clojure 的 future 和 deref 就很容易理解。

此外,(deref ref) 可以简写为 @ref。不过用 @ 语法糖的话就用不了 deref 的超时控制。(deref ref) 默认会一直等待,如果 ref 的值一直没来,程序就会卡死;可以用 (deref ref timeout fallback) 做超时控制,如果经过了 timeout 毫秒还没能解引用成功,就用 fallback 值。

在继续之前我还要提醒对异步编程不那么熟悉的读者,无论是哪种异步机制,无论怎么实现并发,线程的执行顺序都是不固定的。

(dotimes [number 10] (future (println number)))
;; 05
;; 423
;;
;; 8
;; 9
;; nil1
;; 7
;;
;;
;; 6

上面的输出很乱,原因在于 println 的换行符何时打印也不能确定,dotimes 本身的返回值 nil 也混在这些换行得乱七八糟的数字当中。

有办法能控制并发的执行顺序,但要保证顺序必然要有等待、排队的过程,速度就有损失,甚至有可能变成串行的。如果要严格同步,那就不应该异步——是的,这是句废话。总之,需要严格保证执行顺序的操作不该异步。

不阻塞的异步

尝试解引用 future 返回的引用可能会阻塞当前线程,如果希望当前线程不被阻塞呢?有时候我们并不需要严格同步数据,如果新值没有到达,那就用旧的值。

比方说我们有个计数器,每 5 秒给计数器增加 1,解引用这个计数器就拿到当前的数,而不是等五秒过后再拿新的数。

要这么做,可以用 agent:

(def counter (agent 0))
;; => #'user/counter

@counter
;; => 0 

(future 
 (doseq [_ (range)] 
 (Thread/sleep 5000) 
 (send counter inc)))
;; => #object[clojure.core$future_call$reify__8574 0x4abf3f0 {:status :pending, :val nil}]

@counter
;; => 0 

;; 五秒过后 
@counter
;; => 1

doseq 宏接收类似 let 的绑定,用于遍历序列。(doseq [item data] (f item)) 相当于 (doall (map #(f %) data))——如果不需要操作集合数据,比起 map 和 doall,doseq 宏看起来更干净。

上述代码中传入的是无穷的惰性序列,所以会无限循环。每次循环都让线程先睡五秒钟,然后再执行操作。放在 future 里是为了不阻塞主线程。

这里的 send 函数是专门和 agent 一起用的,作用是把一个函数发送给 agent,让 agent 对自己保存的数据做处理。这个过程是异步的,send 会立刻返回 agent,之后再解引用 agent 就能拿到 agent 当前的值。

agent 是线程安全的,不必手动加锁。

你可能发现了,这难道不是非常不函数式吗?比方说,如果不把 agent 用于异步编程,我们完全可以违反「不允许可变状态」的规则,做这种事情:

(def counter (agent 0))
;; => #'user/counter

(deref counter)
;; => 0 

(send counter inc)
;; => #object[clojure.lang.Agent 0x2f6bbeb0 {:status :ready, :val 1}]

(deref counter)
;; => 1

(send counter inc)
;; => #object[clojure.lang.Agent 0x2f6bbeb0 {:status :ready, :val 1}]

(deref counter)
;; => 2

这就要靠程序员的自觉了。不过,agent 其实没那么好用,因为只能发送函数,而不能替换值本身1,用途很有限。

agent 可以存任何类型的值,也可以存集合类型,比方说我们可以一次性给 agent 发多个函数,而每个函数的返回值都是由旧集合拼接成的新集合,就可以并发地处理多个数据。比方说,下面是一个简单的并发爬虫,把数个 HTML 页面塞进了同一个向量里:

(defn crawl [url] 
 (:body (client/get url)))

(defn crawl-append [old url] 
 (conj old (crawl url)))

(def crawler (agent []))

(def urls ["https://chlo.is"
 "https://www.geedea.pro"
 "https://blog.cytrogen.icu/"])

(doseq [url urls]
 ;; crawler agent 里面已经有的值会作为 crawl-append 的第一个参数 
 ;; 后续传入的可变数量的参数(如这里的 url),会变成 crawl-append 剩下的参数
 (send crawler crawl-append url))

@crawler
;; 会返回由当前已经爬取完成的 HTML 字符串组成的向量

对于这种结构简单、数量确定的操作,还可以使用 pmap(parallel map),也就是并行版本的 map。下面这段代码是并行的(准确来说是并发),不需要 agent 也不需要 deref。

(pmap crawl urls)
;; 会返回包含所有爬取结果的惰性序列

pmap 返回的是“半”惰性序列,这些 crawl 其实已经执行了,只不过没有把值返回过来,只有在读取惰性序列的时候才会得到值。pmap 底下用的是 future。

如果要用 map 处理耗时较长的任务,就可以考虑换成 pmap 同时处理。

;; A function that simulates a long-running process by calling Thread/sleep:
(defn long-running-job [n]
 (Thread/sleep 3000) ; wait for 3 seconds
 (+ n 10))

;; Use `doall` to eagerly evaluate `map`, which evaluates lazily by default.

;; With `map`, the total elapsed time is just under 4 * 3 seconds:
user=> (time (doall (map long-running-job (range 4))))
"Elapsed time: 11999.235098 msecs"
(10 11 12 13)

;; With `pmap`, the total elapsed time is just over 3 seconds:
user=> (time (doall (pmap long-running-job (range 4))))
"Elapsed time: 3200.001117 msecs"
(10 11 12 13)

上面这个例子来自 ClojureDocs 。

你可能好奇,如果 pmap 处理大量的数据,比方说一不小心传了个无穷序列进去怎么办?这会同时处理无穷个数据,把 CPU 撑爆吗?老实说,我不知道具体会发生什么,但大概率 Clojure 或 Java 会控制最大并发数,根据当前负载,把过多的请求串行化以减轻压力。

无论有没有这种说法,程序自己完全不控制并发数量也是不行的。无论是 future 还是 agent,貌似都没有提供很好的并发控制机制,难道只能一开始就少派发任务吗?如果不确定有多少任务要运行呢?

Gopher?是你吗?

命名空间 clojure.core.async 提供了另外一种异步编程的方式,但没有放在标准库里,必须要添加依赖才能使用。

;; deps.edn 
org.clojure/core.async {:mvn/version "1.9.865"}
;; leiningen
[org.clojure/core.async "1.9.865"]

core.async 几乎和 Go 语言异步编程的要素一模一样,尤其是 go block——把语句放在 go block 里面,语句就会异步执行。把消息队列 chan 当作一等公民的做法,也如出一辙。根据 Clojure 官方的博客文章 ,这种异步编程风格其实有一段历史了,Go 也是借鉴并现代化了这种做法。

The roots of this style go back at least as far as Hoare’s Communicating Sequential Processes (CSP), followed by realizations and extensions in e.g. occam, Java CSP and the Go programming language.

无论如何,让我们来看看怎么用 go 和 chan 实现异步编程吧。如果你已经会写 Go,那么接下来的代码会很熟悉。

(require '[clojure.core.async :refer [go chan >! <!]])

(def queue (chan))

(go 
 (>! queue "Hello?"))

(go 
 (println (<! queue)))

上述例子中,我们启动了两个 go 线程,一个线程把 "Hello" 放进 queue 里,另一个线程把 "Hello" 取出来。

chan 函数用于创建 channel(频道),可以理解为消息队列。对于 channel,有放(put)和拿(take)的操作,分别用 >!(放)和 <!(拿)表示。这里的 ! 类似于 ?,是 Clojure 的命名习惯,用于标识会对状态进行变更的操作。说到底,我们的确对状态进行了变更,上述语句缺乏引用透明性,不够函数式。

chan 可以设置缓冲区大小,(chan 5) 就是缓冲区大小为 5 的队列,一旦队列满了,再试图往里面放消息,放消息的线程就会被阻塞。

(def only-put-once (chan 1))

(go (>! only-put-once 1)
 ;; 下面这个操作会阻塞这个 go 线程
 (>! only-put-once 1))

反之,如果队列空了还试图从里面拿东西,就会阻塞拿消息的线程。

(def empty-chan (chan))

(go (<! empty-chan)
 ;; 除非有人往 empty-chan 里放东西
 ;; 否则下面这句话不会被打印
 (println "Help! I'm blocked!"))

go 在 Clojure 里是个宏,在 Go 里是个放在函数调用之前的关键字,效果都是让语句异步执行。不过 Clojure 中的 go 会返回一个 channel,go block 里的语句执行完成后,会把返回值通过 channel 传递回来。2

放和拿的操作可以阻塞线程,因此可以用作并发控制。

学过操作系统的读者可能知道信号量(semaphore),我们可以用 chan 实现简单的信号量。比方说,我们先给一个 chan 存入 50 个信号,然后启动不定数量的 go 线程,但在启动线程之前,派发器必须要拿到信号量才行。如果信号量不够(尝试从空队列里取数据),就会阻塞派发器所在的线程,直到有信号量被回收。

(require '[clojure.core.async :refer [go chan put! <!! >!]])
;; 定义信号量
(def semaphore (chan))
;; 将 50 个空 map 放入信号量中
(dotimes [_ 50]
 (put! semaphore {}))
;; 启动一个无限循环派发器
(doseq [number (range)]
 ;; 尝试获取信号量,如果已经消耗完 50 个,阻塞派发器
 (<!! semaphore)
 ;; 获取到信号量时,启动 go 线程
 (go (Thread/sleep (rand-int 10000))
 (println number)
 ;; 线程工作完成后,把一个信号放入 semaphore
 (>! semaphore {})))

上述程序永远不会同时运行超过 50 个 go 线程。也可以反着实现,定义大小为 50 的 channel,每派发一个线程之前都要放个东西到 channel 里,比如 {}3,放满了话的话就阻塞。不妨试着在 REPL 里写一写试试?

需要注意的是放和拿的操作有很多变体,在不同场景下使用。之前提到的 >! 和 <! 只能放在 go block 中,放在其他地方会报错。

在 go block 外,可以用 >!! 和 <!!,一般不建议用,因为会阻塞主线程。更好的选择是 put!(放)和 take!(拿),这两个操作是异步的,无论放没放进去、拿没拿出来,都不会阻塞当前的线程(但是会阻塞异步的子线程)。

由于 take! 是异步的,不会立刻返回值,所以得传一个回调函数给它,这样在能拿到值的时候,就会调用回调函数。下面是 ClojureDocs 的示例:

user=> (def c (chan 1))
#'user/c

user=> (take! c
 (fn [x]
 (println "Clojure callback value " x)))
nil

user=> (put! c "XYZ")
Clojure callback value XYZ
true

user=> (put! c "XYZ")
true

此外还有 offer!(放;给)和 poll!(拿;查),这两个操作是同步的,但也不会阻塞线程。offer! 会检查 channel 的缓冲区是不是满的,如果满了就返回 nil,如果能放进去就返回 true;poll! 也类似,能拿就拿,不能拿就返回 nil。

像 Go 程序员一样写 Clojure

Go 语言程序经常用 goroutine4 和 channel 实现各种并发处理管线。我刚才已经演示了两个线程(协程)用 channel 异步通信,演示了派发器和并发控制。我们还可以把更多 Go 语言的编程模式搬到 Clojure 里来。

我前面提到,core.async 提供的这套异步编程模式很不函数式,因为 channel 就是存放状态的队列,与之相关的放和拿的操作也不具有纯函数应有的引用透明性。

不过这是否值得呢?接下来我要用 Go By Example5 网站上的 Stateful Goroutines 的例子回答这个问题。

 reads := make(chan readOp)
 writes := make(chan writeOp)

 go func() {
 var state = make(map[int]int)
 for {
 select {
 case read := <-reads:
 read.resp <- state[read.key]
 case write := <-writes:
 state[write.key] = write.val
 write.resp <- true
 }
 }
 }()

select 经常和 chan 一起用,放在 select 的哪个 case 中的 chan 先来消息,就先执行哪一个 case,也就是说可以同时等待多个 chan。

上述代码中的 goroutine 管理了一个状态 state,即 stateful goroutine。它接收其他 goroutine 通过 channel 传递过来的消息,然后通过消息里携带的 resp(也是个 channel)把处理结果写回那些 goroutine。

简单来说,这个 stateful goroutine 接收读操作和写操作。读者和写者不持有状态,只是发消息给 stateful goroutine,让它帮忙管理状态,然后给它一个 channel,稍后把处理结果发送回去。

 for range 100 {
 go func() {
 for {
 read := readOp{
 key: rand.Intn(5),
 resp: make(chan int)}
 reads <- read
 <-read.resp
 atomic.AddUint64(&readOps, 1)
 time.Sleep(time.Millisecond)
 }
 }()
 }

上述代码派发了 100 个读者 goroutine,每个 goroutine 都把封装好的读操作写入 reads channel,然后等待 resp 被发回来。相对应地,还有写者 goroutine,这里就略过了。

不知道你有没有注意到几件事:

  1. 管理状态的 goroutine、读者和写者之间,是解耦的,我们只需要有一个中间人(比方说 main 组件)把 channel 发给他们,他们就可以在没有代码依赖的情况下相互通信
    • 这很方便测试,假设我要测试 Stateful goroutine 是否工作正常,我不需要启动读者和写者,我只需要把测试数据写入 reads 和 writes。
    • 这让架构变得灵活,我可以随意重构三个组件,完全不会互相影响,不会出现某个组件的函数签名改了,另一个组件的函数调用也要改的情况。
  2. 我们把状态管理集中到了一个组件里,读者和写者可以是无状态的。
    • 函数式编程的重点就是要管理状态和副作用,用 goroutines 和 channel 把状态管理集中到一个组件,也算是殊途同归了。
  3. 三个组件在共享数据,但是完全不需要加锁!

要在 Clojure 里实现类似 select 的结构,可以用到 alt!(alternative)。

;; (go-loop ...) = (go (loop ...))
(go-loop [state {:key "val"}]
 (alt!
 reads ([read-op] 
 (>! (:chan read-op) ((:key read-op) state))
 (recur state))
 writes ([write-op]
 (recur (assoc state (:key write-op) (:val write-op))))))

不过,如你所见,除了 >!,这比 Go 语言的版本要更函数式一些,因为我们没有给 state 赋值,而是在 recur 一次又一次的递归调用中,不断给 go-loop 传入了不同的参数而已。

我不久前就在工作中解决了一个不大不小的性能问题:系统中有大量 goroutine 等待 SQLite 的锁,导致计算资源闲置,而要写入 SQLite 的数据不过是些日志,并不着急同步。于是,我的解决方式是引入一个写者,所有写入数据库的操作都通过 channel 传递给这个写者,由写者这一个实体写数据,这样就不需要锁了。其他 goroutine 把写操作的情况放入 channel 之后就可以继续做自己的事情,不必等着把日志写进数据库。6

把副作用、状态管理和 I/O 操作集中在系统的一个组件,通过 channel 解耦其他组件与状态管理组件,能很好地降低系统的复杂性。

我应该用什么?

future 和 deref 很简单,agent 和 send 似乎也不错,go 和 chan 更是能很好地管控系统的复杂性,我究竟应该选哪个?

老实说,我觉得这是程序员需要多写代码才能建立起来的认识。读者应该在实际的场合下权衡取舍,而不是选定一个万金油方案。这些方案都有利弊。

future 和 deref 基本对应 JavaScript 的 async 和 await——轻量,易用,非常函数式。可如果要构建复杂系统,严格控制并发,甚至根据系统负载动态调整并发度,这种轻量的方案就不太适用了。

agent 和 send 的模型更关注数据处理,毕竟 agent 在创建时就需要指定初始值,而 send 的作用是给 agent 发送一个操作,对其中的数据做操作。再者,agent 天然就是并发安全的,可以减少自己加锁的麻烦。处理数量可控且相对轻量的数据时,就可以用 pmap。

go 和 chan 就跟它们在 Go 语言里的地位一样,如果要开发高并发的复杂系统,或者管理系统的复杂性,将组件解耦,就可以抱着抛弃函数式风格的代价使用。core.async 其实遭到了 批评 ,而且的确有一些问题。Stack Overflow 上的 aeuhuea 就举了个很典型的例子:

(defn take-and-print [c]
 (println (<! c)))

(def ch (chan 1))
(>!! ch 123)

(go (take-and-print ch))
;; Assert failed: <! used not in (go ...) block

上面的代码报错了,因为 <! 和 >! 如果被放在函数里面,就会被认定没有按规定放在 go block 里,哪怕函数就是在 go 里面调用的。我一般的解决方法是把 <! 取出的值作为参数传递给函数,或者用宏。

最后

异步编程很难不考虑状态,我还真的有点好奇 Haskell 作为纯函数式编程语言,不像 Clojure 这样容忍一部分的可变状态和副作用,是怎么实现异步的。我得找时间去研究研究。

这些概念可能不太好理解,我希望我讲清楚了。如果你有任何问题,或者发现了我有疏漏的地方,欢迎给我发邮件。那么,回见!


  1. 其实可以给 agent 发这样的函数:(fn [_] "new value") ↩︎

  2. 说实话,很少用 go 返回的 channel 取返回值,因为不如 future 和 deref 方便。 ↩︎

  3. 在 Go 语言里,空结构体 struct{} 不占空间,所以经常用来做信号量放进 channel 里。Clojure 的空映射 {} 底层是个 Java 类,不可能不占空间,这里只是我自己的习惯,你可以换成 true、:signal 之类的,但是不能放 nil,会报错,因为 nil 在某些操作里表示 channel 关闭了或者空了。 ↩︎

  4. 即协程,是 Go 语言建立在线程之上的用户级、轻量的并发单元,用 go 启动。Clojure 里的 go 仅仅是借其形式,不见得和 goroutine 一样轻量(我们可是在 Java 虚拟机上啊!)。 ↩︎

  5. 这个例子由 Mark McGranaghan 和 Eli Bendersky 编写,用 CC BY 3.0 协议 授权。我只截取了其中的一部分。 ↩︎

  6. 唯一的缺陷是,如果程序意外退出,而 channel 里还有些日志没写入数据库,这些数据就丢失了。 ↩︎

打领带的人

最近在关注 Golda ,从 ch0ccyra1n 写的 Issues 来看,她近期并不打算推进太多功能开发,更多是在做各个平台的发包和新 Fork 落地的工作,还有清理 Hugo 的某些遗留问题(比如 Hugo 的传递依赖太多导致不太容易打包到 Guix 的 问题 )。我在帮忙移除了 hugo deploy 之后也找不到什么能帮忙的事情了。

不过我在尝试把博客从 Hugo 迁移到 Golda 的时候,发现我依赖的某些较新的 API 没有被 Golda 实现。我去翻了 Hugo 的更新日志和相关的 commit,发现这些功能有不少是用 Claude 写的,不能拿来用。Hugo 也废弃了某些 API。这样下去,Golda 的 API 会和 Hugo 的变得越来越不容易兼容,但一直盯着 Hugo 更新,等人重新实现他们用大模型生成的功能,也不现实。关于此事,我提了 Issue ,与维护者基本达成一致。不过,这也意味着我要为了消除 LLM 写的代码,耗费好多精力修改我原来的代码。

事情进行到这里的时候我已经觉得有点心累,一方面是因为我在 一百零一期周刊 里提到的道德矛盾感,另一方面是我愈来愈清晰地意识到,要远离自己讨厌的技术已经变得完全不可能。很快,矛头转向了我自己。我知道这种自我攻击不健康,但若是不表达出来,伤害恐怕会更大。 既然感受是真实的 ,那就写吧。


难道你要事无巨细地检查你每个项目里的每一个依赖项,以及这些依赖项的依赖项,追溯整个供应链,确保里面没有模型生成的代码吗?你在想什么?光是找到符合你条件的桌面端应用都很费力了,你现在用来写文的 Neovim 也不全是人类所写,而据我所知,你还不想进入 Emacs 世界。你之前提到你对不开源的专有软件还有些包容度,那你怎么知道那背后的程序员是怎么工作的?你自己工作也一直用 Agent,你对待那些提交到公司内网的代码,也不如你对待提交到 Codeberg 和 Hydra 的用心。你也非常清楚,早在 LLM 之前,就已经有数不清的讨厌写代码(或者只是讨厌上班)的程序员在写他们不喜欢的软件了。你到底在要求什么?

你说你能理解那些人。你理解有的人想要脱离职场的苦海,求助于这生来就不洁的技术,抱着投机的心态创业,指望做出爆火的产品解救自己的生活。你说你看见了他们的挣扎,却还是在读到他们用 Codex 和 Claude Code 时心头一震。你能要求他们去看看背后发生了什么吗?你说你理解有的人带着一种愚昧无知的上进心,理解他们关注“时代发展方向”,使用这项技术不过是为了自己的职业生涯考虑,是在适应变化。你自己也在做这样的事情,你深知你不在简历上写自己的 Agent 使用经验和上下文管理技巧就会被市场淘汰,你也在适应变化,你也是车轮下的蚂蚁。你与他们唯一的不同是,你非常清楚自己在车轮之下,而不是在风浪之上,你非常清楚自己随时会被轧死,而这不会让你变得更容易在车轮下生存,只会让你更容易陷入绝望。

职场前辈对你随口说的某句话你难以忘却。那天上午你没有工作,给 Golda 提交了代码之后,午餐时聊起此事,但避开了与大模型有关的词句。你说你给开源项目提 PR,前辈说挺好,“可以丰富自己的简历”。你总觉得自己没有背叛那个每天下午坐在电脑面前发现一个个奇迹的孩子,可你总归还是背叛了。那个孩子从来不会想到,追随自己的好奇心和他逐渐锻炼起来的品味,最终导向的仅仅是简历上的一行字,甚至写不进简历,因为没有人在乎你用 SSG 做网站、用 Lisp 写代码、用终端还是 IDE 做开发(神奇的是,他们很在乎你用不用大模型写代码,有没有跟上趋势)。

你说你清楚,你知道,人们只在乎成果。你也认可,你也不在乎某个数学家在证明某个定理时是否感到心潮澎湃。你知道你只需要交付可靠的软件(有很多时候,他们只要求你快速交付能符合短期要求的软件),没人在乎你用的是不是你喜欢的语言,没人在乎你用了什么设计模式,没人在乎你的代码整不整洁(“以前古法编程确实这有这个说法,现在都用 AI 写了啊”)。如果可以,他们真想完全除掉代码,而且他们已经这么干了。如果可以,你也想除掉数学、除掉昆虫、除掉令人大脑萎缩的短视频,而你也已经这么干了。你致力除掉你讨厌的东西,他们致力除掉他们讨厌的东西;你朝你的目标前进,他们朝他们的目标前进。

你多想声称,这个世界太多的问题,都源于人们非要做自己不喜欢做的事情。有人不喜欢讨论软件架构、代码整洁、新的编程语言、系统的可维护性,所以他们渴求从未存在也不会存在的 银弹 ,他们用卑劣的技术除掉那些他们从来就不想要考虑的事情。有人不喜欢打领带,但非要系领带,所以发明了可笑的免打领带。可真是侮辱了领带这精巧漂亮的配饰呢。“这么方便,为什么不用?”“忙得很呢,哪有时间留给你打领带?”“这都不用。傻逼。”于是,你看着街上所有的人都戴着扣上的或套上的领带,假笑着称赞对方的领带有多么紧随潮流。人们走向你,问你的领带是扣上的还是套上的,你说你是手打的,他们开玩笑说这是古法系领带,你不解,古时候人们不系领带。又有人走向你,问你是要出席什么正式场合,你说你想在城市里散步,去看花、喝咖啡,你说你只是喜欢打领带。他们又困惑了。你说你喜欢用红色的领带配白衬衫和牛仔裤,喜欢用橙色的衬衫和绿色的领带扮演橘子,你说你尝试过薰衣草色的衬衫和紫色的领带。他们不懂为什么要在乎这些,把他们海军蓝色、没有花纹的领带扣在了衬衫上,转身走进了摩天大楼,以为遇到个怪人。

有时候你真不想理解其他人,你多想自己的世界再小一点,跟你的父亲一样坐井观天,做个烦人但自洽的幸福人。或许你可以做 Stallman 那样的人,抱有强烈的观点且决不退让,哪怕因为太冒犯人,被人写 长文 谴责,也总归还会是幸福的。可惜,你我都很清楚,你做不了那样的人,那样的人让你恶心想吐。你也融入不了大众,更成不了精英,哪个阵营都让你恶心想吐。你多想引用陈词滥调,散发着爹味对自己说:“这世界这么大,总归有你的容身之处。”可你不会信的。

Coffee Break Clojure, Web Server

上一篇 讲解了如何用 Leiningen 管理 Clojure 项目的目录结构和依赖项,今天我们来了解 Clojure 生态中最常见的 Web 后端库 Ring 。不对,和那个 IndieWeb Ring 没有关系。

初识 Ring

Ring 是对 Web 服务器的低层抽象,也就是说没有实现页面路由(router),和通常的后端框架(比如 Go 的 Gin、Python 的 Django、Java 的 Spring Web 等)有很大区别。

根据 Ring Spec 1.6.1 ,Ring 主要有三个概念:

  1. Handler(处理器)
  2. Middleware(中间件)
  3. Adapter(适配器)

Ring 提供了三种 API: 同步 API、异步 API 和 WebSocket API。不同的 API 在概念上略有不同,我们先从最简单的同步 API 讲起。

Handler 就是一个函数,接收 HTTP 请求,返回 HTTP 响应。

;; 一个示例 Handler
(fn [request] response)

异步 API 的区别不大,只不过,由于 Handler 的结果需要异步返回,如果出了错也要异步报错,所以要传入两个回调函数用来响应和报错。

(fn [request respond raise]
 (if (not exception)
 (respond response)
 (raise exception)))

一个 Handler 可以同时实现同步和异步 API。

(fn
 ([request]
 response)
 ([request respond raise]
 (respond response)))

Middleware 接收一个或多个 Handler,也可能接受一些参数,最后返回新的 Handler。可以理解为设计模式中的装饰器模式(decorator pattern),用来调整或增强 Handler 的行为,比如把 Handler 返回的响应体都解析成 JSON 字符串。

Adapter 接收一个 Handler 和其他配置参数,在调用时启动 HTTP 服务器。

;; 调用一个 Adapter 的示例
(run-adapter handler options)

把 options 设置成 {:async? true},Adapter 就能以异步模式运行了。前提是 Handler 支持异步 API,Adapter 也要支持 :async? 才行。异步 API 可以让服务器并行处理多个请求,如果对并发度有要求可以用。

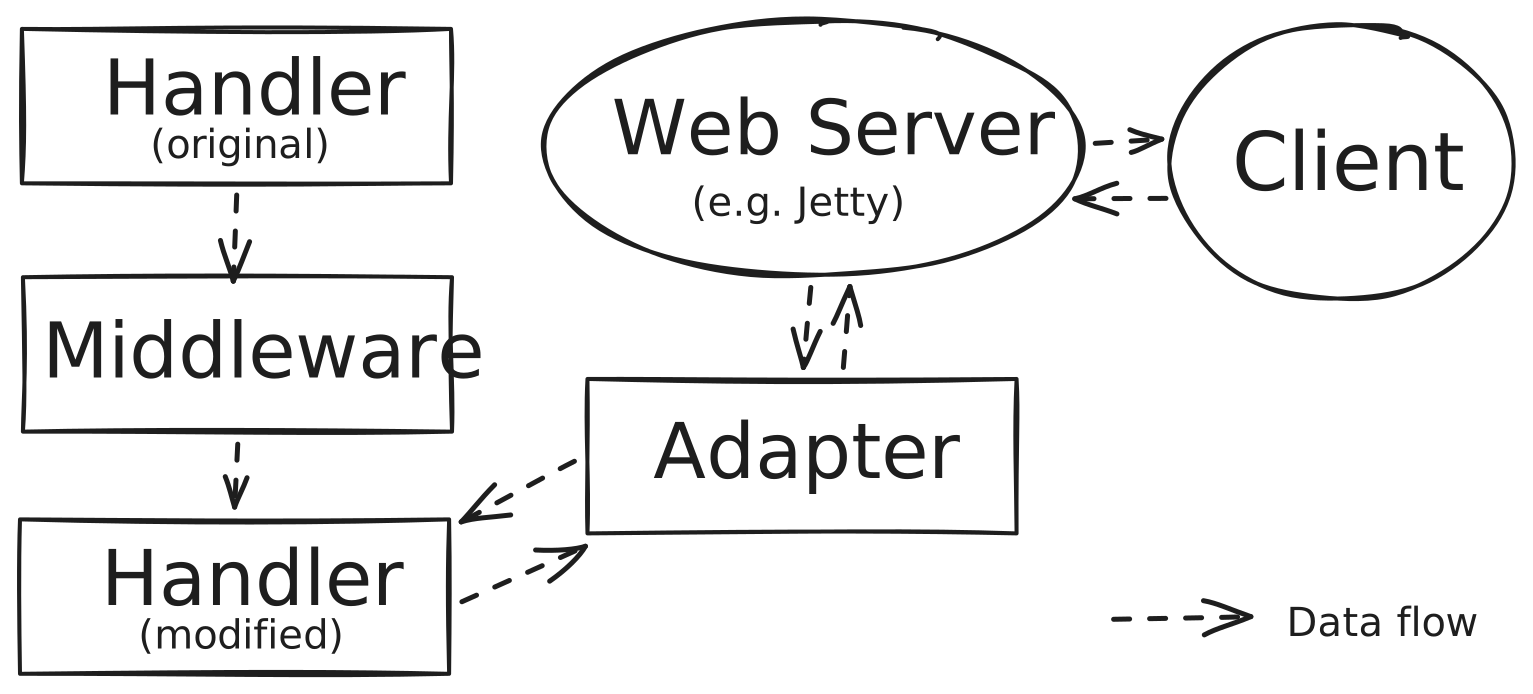
接收 HTTP 请求的就是 Adapter,他会把请求包装成 Request Map 传递给 Handler,随后把 Handler 返回的 Response Map 构造成 HTTP 响应发送给客户端。可以把 Adapter 理解为设计模式中的代理模式(proxy pattern),用户不直接调用 Handler,而是通过 Adapter 调用 Handler,Adapter 会处理 HTTP 协议相关的细节。

图片由我使用 Excalidraw 绘制

上述组件其实都不必有代码依赖关系,因为函数可以作为数据传递,上图的虚线都表示数据流。Handler 先是经过 Middleware 被改装成了新的 Handler,然后被传入 Adapter;Adapter 在 Web 服务器有请求进来时调用 Handler 产生响应数据,把响应数据包装成响应体后传送给客户端。

简单的 Web 服务器

先在 project.clj 里添加两个新依赖:

 :dependencies [[org.clojure/clojure "1.10.1"]
 [ring/ring-core "1.8.2"]
 [ring/ring-jetty-adapter "1.8.2"]])

其中一个是 Ring 的核心库,另一个是 Jetty1 的 Ring Adapter。ring-core 也提供了一些 Middleware,我们其实只需要写 Handler。

创建 src/antfigher/handler.clj,antfigher 是我用来演示的项目名。我们先让 Handler 只返回 Hello! 这一条信息。

(ns antfighter.handler)

(defn handler [request]
 {:status 200 
 :body "Hello!"})

接下来需要启动 Web 服务器,如果你安装了上一篇提到的 lein-ring 插件,就可以直接用命令行启动了。在 project.clj 中添加这些配置:

 :plugins [[lein-ring "0.12.6"]]
 :ring {:handler antfighter.handler/handler}

:plugins 安装了 Ring 插件,:ring 则是这个插件的配置项,其中 :handler 指定了 antfigher.handler 命名空间下的 handler 符号,也就是我们刚才定义的 handler 函数。

在终端输入 lein ring server 启动服务器,之后工具会自动在浏览器里打开 http://localhost:3000,然后就能看到 Hello! 显示在浏览器页面里。

如果要打包成可以直接在 JVM 上执行的 .jar 文件,可以用 lein ring uberjar 编译。不过,我不建议依赖这个 Leiningen 插件来编译应用,而且不少应用其实除了启动 Ring 服务器,还需要启动别的东西,比如后台处理线程、消息队列等等。lein ring uberjar 只会把指定的 Handler 编译进去。

在 core.clj 文件的 -main 函数里编写启动逻辑:

(ns antfighter.core
 (:gen-class)
 (:require [antfighter.handler :refer [handler]]
 [ring.adapter.jetty :refer [run-jetty]]))

(defn -main
 "I start a Jetty server."
 [& args]
 (run-jetty handler {:port 3000}))

run-jetty 就是 Ring Jetty Adapter,它接收 handler 函数和作为配置项的映射,这里我们传入的配置是 {:port 3000},也就是在 3000 端口上启动 Jetty 服务器。

这时运行 lein run,再手动打开 localhost:3000,也能看到 Hello!。如果用 lein uberjar 把项目编译成 .jar,然后用 java -jar xxx.jar 运行,也是一样的效果。2

开发时建议用 lein ring server,因为自带热重载,保存代码后就能看到效果。

处理 HTTP 请求

Handler 接收的参数 request 是个映射,结构如下:

Key Type Required
:body java.io.InputStream
:headers {String String} Yes
:protocol String Yes
:query-string String
:remote-addr String Yes
:request-method Keyword Yes
:scheme Keyword Yes
:server-name String Yes
:server-port Integer Yes
:ssl-client-cert java.security.cert.X509Certificate
:uri String Yes

Handler 也应该返回一个映射,结构如下:

Key Type Required
:body ring.core.protocols/StreamableResponseBody
:headers {String String} or {String [String]} Yes
:status Integer Yes

上述表格摘自 Ring Spec 。大部分情况下我们都只需要使用 :body 和 :headers,也就是响应头(或请求头)以及响应体(或请求体),响应时还需要带上 :status,即 HTTP 状态码。

当然,如果你不用任何路由库,纯手动路由,那还要用到 :request-method(请求方法,如 GET POST)和 :uri(用来解析路径)。

Handler 做的事情其实就是对请求做些处理,然后构造响应。比方说,如果客户端用 GET 方法请求 /hello 目录才返回 Hello!,对其他路由都返回 404 和 Not Found,就可以这样写:

(ns antfighter.handler
 (:import [java.net URI]))

(defn handler [request]
 (let [method (:request-method request)
 uri (:uri request)
 path (.getPath (URI. uri))]
 (if (and (= method :get)
 (= path "/hello"))
 {:status 200 
 :body "Hello!"}
 {:status 404 
 :body "Not Found"})))

不过,访问 /hello 会得到 Hello!,但访问 /hello/ 却是 Not Found。我们的路由匹配方式有缺陷。处理这些细节太麻烦了,有没有别的办法?

沉着冷静地路由

Compojure 是 Ring 的主要贡献者 weavejester 维护的路由库。这个名字显然来自 Composure,意思是「沉着冷静」。

如果要新建项目的话,其实可以直接用 Leiningen 的 compojure 模板:

lein new compojure hello-world

不过我自己的感受是,不用脚手架从零搭建会减少很多认知负债,在一开始就把各种组件、依赖关系和架构搞清楚是最好的。熟悉之后再图方便使用模板。

下文提及的符号基本都定义在 compojure.core 命名空间里,读者应该会使用 require 引入符号(如果不会,就去读 上一篇 ),我就不写 require 了。

Compojure 的核心是 routes 函数,用来把多个 Handler 组合成一个。一般和 GET、POST、PUT 等路由宏一起使用,每个宏对应一个 HTTP 方法,可以用 ANY 宏匹配任意方法。这些宏展开之后,最终返回的是对应方法和路径的 Handler。

(def api-routes
 (routes 
 (GET "/hello" request (handle-hello request))
 (POST "/receive" request (handle-receive request))))

(run-jetty api-routes {:port 3000})

上述代码可以简写为:

(defroutes api-routes
 (GET "/hello" request (handle-hello request))
 (POST "/receive" request (handle-receive request)))

(run-jetty api-routes {:port 3000})

request 可以直接传给处理逻辑,也可以解构(destructure)之后再传递:

(defroutes api-routes
 (GET "/hello" [username] (say-hello username))
 (POST "/receive" [data] (receive data)))

放在向量里的符号会被自动绑定到对应名称的 Query String 或 POST 参数上。

curl http://localhost:3000/hello?username=Alice 
# => Hello Alice!

Compojure 也可以用 Clojure 自带的 解构 ,比如把数据从 Session 里取出来:

(GET "/user" {{:keys [user-id]} :session}
 (str "The current user is " user-id))

关于解构,一般用向量取出 Query 和 POST 参数就够了,更多用法可以参考 Compojure Wiki 。如果觉得解构的语法太麻烦,直接用 Request map 也没有问题。

这些宏也天然支持动态路由:

;; 路径中的 :username 会被绑定到 username 符号上
;; 下面的路由会匹配所有形如 /hello/* 的 GET 路径
(GET "/hello/:username" [username] 
 (say-hello username))

;; 可以用正则表达式做更严格的匹配
(GET ["/user/:id", :id #"[0-9]+"] [id]
 (get-user id))

路由可以嵌套,要用到 context 宏,参考 Wiki 里的例子:

(defroutes user-routes
 (context "/user/:user-id" [user-id]
 (GET "/profile" [] ...)
 (GET "/posts" [] ...)))

如果一个请求发过来,没有匹配上任何一条路由,那么 Compojure 会返回 nil。我们还没处理 Not Found 路径。可以用 compojure.route 里的 not-found 函数处理 404 请求。

(require '[compojure.route :as route])

(defroutes api-routes
 (GET "/hello" [username] (say-hello username))
 (POST "/receive" [data] (receive data))
 (route/not-found "Not Found"))

Compojure 不仅帮我们解构 request,还可以智能地处理 response。比如,我们可以把 GET "/hello" 这个路由的响应替换成字符串。

(defroutes api-routes
 (GET "/hello" [username] (str "Hello " username "!"))
 (POST "/receive" [data] (receive data))
 (route/not-found "Not Found"))

"Hello Alice!" 会被自动包装成:

{:status 200
 :headers {"Content-Type" "text/plain; charset=utf-8"}
 :body "Hello Alice!"}

构造这种响应体可能很麻烦,除了让 Compojure 自动处理(说实话,我觉得自动处理有点令人捉摸不透,自己写清楚会好点),还可以用 ring-http-response 工具库:

(require '[ring.util.http-response :refer :all])

(continue)
; {:status 100, :headers {}, :body ""}

(ok "body")
; {:status 200, :headers {}, :body "body"}

(created "url" "body")
; {:status 201, :headers {"Location" "url"}, :body "body"}

(found "url")
; {:status 302, :headers {"Location" "url"}, :body ""}

自由组合中间件

Compojure 能帮我们处理路由、请求体的解构和响应体的封装,但内部结构并不复杂,这些功能是通过 Middleware 实现的:

(defn make-route
 "Returns a function that will only call the handler if the method and path
 match the request."
 [method path handler]
 (-> handler
 (wrap-response)
 (wrap-route-middleware)
 (wrap-route-info [(or method :any) (str path)])
 (wrap-route-matches method path)))

这些 wrap- 开头的函数就是 Middleware,最初的 handler 作为参数被传入这些函数,一层层被包装。wrap-response 给 Handler 增加了自动包装返回值(响应体)的能力,wrap-route-matches 则保证只有请求体里的方法和路径都匹配时才放行。

还记得 defroutes 定义的符号也是个 Handler 吗?Compojure 的路由不过是把多个匹配不同路由的 Handler 组合成了一个大的 Handler。Handler 就是这样被组合、装饰才变得支持多路由和各种额外功能的。

我们还可以继续包装 Handler,比如用 ring-json 库,把响应体 :body 里的 Clojure 数据结构自动解析为 JSON 字符串:

 :dependencies [[org.clojure/clojure "1.10.1"]
 [ring/ring-core "1.8.2"]
 [ring/ring-jetty-adapter "1.8.2"]
 [ring/ring-json "0.5.1"]]) ;; <- 新依赖

ring.middleware.json/wrap-json-body 会解析所有 Content-Type 为 JSON 的响应体。

(require '[ring.middleware.json :refer [wrap-json-body]])

(defroutes api-routes 
 (GET "/test" [] 
 {:status 200
 :headers {"Content-Type" "application/json"}
 :body {:message "Cheshire just visited me."}}))

(def app 
 (wrap-json-body api-routes))

(run-jetty app {:port 3000})
curl http://localhost:3000/test 
# => {"message": "Cheshire just visited me."}

如果需要对响应数据做处理,比起放在业务逻辑里增加复杂度,不如写一个 Middleware,对 Handler 进行装饰。如果是相对通用的需求,可以找找有没有已经实现自己需求的库。


其他参考资料

  • 除了 Ring 默认的 Jetty,我个人比较推荐 http-kit ,它提供了简单且性能较好的 Web 服务器实现,可以用 org.httpkit.server/run-server 替代 run-jetty。这个库也提供了 HTTP 客户端实现。

  • 除了 Compojure,还有更新更现代的 reitit ,不过仍处于 0.x.x 版本阶段,不如 Compojure 稳定。

    reitit 的主要亮点是数据驱动,路由不必写成宏形式,可以写成嵌套的向量:

    (defn cqrs-routes [actions]
     ["/api" {:interceptors [::api ::db]}
     (for [[type interceptor] actions
     :let [path (str "/" (name interceptor))
     method (case type
     :query :get
     :command :post)]]
     [path {method {:interceptors [interceptor]}}])])
    

    上面这个示例来自 reitit 文档。说实话,用 for 循环(或者 map)构造路由看起来很酷,但用宏同样可以做到啊。Clojure/Lisp 代码本身就是数据,不需要什么「数据驱动」。

    不过 reitit 还有别的好处,比如可以在路由里写拦截器(interceptor)。

  • 你可能会想要 Swagger API 文档,有 ring-swagger 这个库,本质上是在 API 路由的定义里添加了一些元数据和文档描述,然后在运行时用这些数据生成 swagger.json,还把 Swagger UI 也打包在内。

    还有专门为 Compojure 设计的 compojure-api ,用 ring-swagger 实现。我试了试,这个库的依赖有点大,打包后可能有十几二十兆。在我看来不如手写文档,除非 API 真的很复杂。


最后

这其实也是我第一次这么仔细地阅读 Ring 和 Compojure 的架构。Ring 的 Handler、Middleware 和 Adapter 其实很优雅,尤其是 Middleware 的组合,以非常优雅清晰也非常函数式的方式拓展了 Handler 的能力。

由于写文的过程中发现了不少之前不了解的细节,所以我打算稍后就去整理一下我项目里的 API 写法。那么,回见!


  1. Jetty 是个 Java Web 服务器;也可以换成别的,这里就用默认的 Jetty 演示了。 ↩︎

  2. 上篇文章提到了,如果要用 Java 运行,就要保留 core.clj 中的 :gen-class。 ↩︎

大脑充血 Vol.101

我一直说周刊是每周一发布,每月正刊也是,从没限定具体时间,就是考虑到了发布当天赶死线的情况。这期周刊的一小半内容都是周一写的,但质量确是我认为创刊以来最佳的一期,也是最长的,超过了一万字。祝阅读愉快。

本月的话题是道德与纯粹性,个人知识管理,市场的辨别力,开源软件与 UX 设计,Clojure 与函数式编程。


吾仅悉落

chapter 1 music cover

chapter 1

girl in red

Girl in Red 是我之前听一个叫 Chloe Moriondo 的翻唱歌手了解到的(当时 Chloe 还在 YouTube 上发尤克里里弹唱的视频,如今似乎变成原创流行歌手了,少了些味道)。

她的不少歌曲描写的都是对女生的爱恋,还有抑郁情绪。貌似不少拉拉会以「你听 Girl in Red 吗?」来辨认身份。我好奇男同会用谁,Taylor Swift 和 Lady Gaga 吗?难不成是 Troye Sivan?

《chapter 1》是她的第一张 EP,至今为止她只发过《If I Could Make It Go Quiet》和《I’m Doing It Again》两张录音室专辑。这张 EP 为她的风格奠定了基础,像是在一个朦胧的午后,半眯着眼睛看这个世界的感觉。

我个人最喜欢的是《i wanna be your girlfriend》和《summer depression》。


心重如毛

如何与自己谴责的人共建友谊?

📻

巴德学院汉娜·阿伦特政治与人文中心的创始人 Roger Berkowitz 近期出版了一本叫作《A World We Share》(我们共同的世界)的著作,讨论友谊与真理的关心。本书聚焦一个十分具有张力的核心问题:友谊比真理更重要的吗?Berkowitz 的答案是肯定的。

2017 年,Berkowitz 邀请了德国极右政客 Marc Jongen 到阿伦特中心的 十周年秋季会谈 讲话,后来还 发文 为他的邀请做辩护。此举遭到了学界同行的共同谴责(顺带一提,汉娜·阿伦特是德国纳粹大屠杀的幸存者),他们写了一封 公开信 谴责他。Berkowitz 本身并不持极右政治观点,他邀请 Jongen 是出于多元(Pluralism)考虑。

当时,签署那份公开信的人当中有他一起吃饭聊天的朋友。

对谈中,Berkowitz 提及了真理的霸权(Tyranny of Truth)这个概念。他说他之前读到了西塞罗(Cicero)说过的一句话,那句话让他读过之后的几年内都感到内心不安:

I prefer, before heaven, to go astray with Plato, your reverence for whom I know, and admiration for whom I learn from your lips, rather than hold true views with his opponents.

我宁愿与柏拉图一同误入歧途——我知道你敬重他,也能从你的言谈中了解你对他的倾佩——也不愿意和他的反对者一同持有正确的观点。

—— Cicero in twenty eight volumes. Vol.18: Tusculan Disputations, P47

如今的世界不是这样的,如今的世界被「哲人王」统治,我们已经接受,我们需要学识超群的人(拥有博士学位的人、政客、科学家)来指导我们的思考。他们说一不二。我们不在乎不同的观点,我们在乎真理(truth over opinion),而真理就是哲人王的观点。

Berkowitz 转述另一位学者的观点,说政治是说服,而非真理,但「共同的世界」并不能靠说服建立。人们面对面交流想法,而不是试图说服持有“错误观点”的人。在交流的过程中,人们意识到互相共有的东西和不能达成共识的东西,基于共有的东西建立起一个「共同的世界」,在这个世界里允许不和存在。

尽管我不太能完全接受「朋友比真理更重要」的观点,但我的确认可,应该允许自己与朋友之间存在不和。友谊就是人们先建立起的「共同的世界」,在友谊中可以包容观点不合。

播客中还谈到了阿伦特自己对友谊的看法,阿伦特认为认识并且有来往并不代表成为了朋友,有时候在外人看起来像朋友的人,阿伦特自己却不会承认,尽管她真的像关心朋友一样关心对方。她认为真正的友谊是需要时间建立的,朋友需要经常面对面说话,需要在各种场合出席,需要相互陪伴。友谊也是具有私密性的,公开的社交场合不是给朋友的,朋友是自己会邀请到家里来小聚的人。阿伦特本人也十分珍重隐私,她的私人生活(包括她与海德格尔的恋情)在去世前从未为世人所知。

在我看来,并不是要和自己有意见冲突的人做朋友,而是要允许自己已经通常长期的交往和陪伴建立起共同世界的朋友,与自己有观点不合。比如,允许他们给自己写公开谴责信,但仍在私下谈天说地,因为私密的友谊和公共生活本身就有区别,这不是伪君子。

甚至说,正是因为有观点的冲撞和关心当中的张力,友谊才能长久,就像动物之间相互扑咬玩耍一样。从人类的层面来讲,允许朋友挑战自己,也有助于塑造人格。

博客中的相关条目: 《如何获得内心的安宁》什么是友谊?


顺带一提,Roger Berkowitz 教授还有 自己的网站 ,不过他并不写博客,这个网站类似于个人名片。可以在网站上了解他的学术成果。

你可能注意到这一小节的链接中没有包含播客名字,因为我想要在最后才揭露这是一期来自《独树不成林》的播客。下一节我们要考虑一个略微不同但与标题相关的问题:我们能完全理性地看待一个有洗稿抄袭前科的人产出的内容吗?我们如何不让自己的道德观念把自己与世界完全隔绝开来?

无法统一的道德观念与技术猎巫

📜

第 95 期周刊 中我提到《独树不成林》主播仲树洗稿抄袭一事。有人发现她发布的好几期播客节目从内容、结构和例证上都与 Old School with Shilo Brooks 等播客十分相似,而舆论发酵后,仲树本人并没有回应,连着发布了三期播客之后,就陷入了一个多月的沉默期。上一节提到的播客是她在那之后发布的第一期播客。

新播客是一起访谈,仲树只是提问者,偶尔提出自己的见解,内容基本都是 Roger Berkowitz 输出的,所以不太可能构成洗稿。不过,先前的洗稿基本上坐实了,她自己也没有为自己开脱。我不能为其他听众说话1,我自己的感想是,这个有洗稿前科的人推出了新的内容,质量很不错,我听完也写了不少感想(见上),但这些内容出自一个“罪人”,所以我现在的心情很复杂。

我最近不是第一次感受到这样的心情了。我们把目光从播客内容生态先移开,来看看日益变得不太平的技术社区。先有 语言模型分裂自由软件社群 、 “AI” 公司损毁珍贵实体书籍 ,后有 科技公司争先恐后给极右分子送钱 、 开发者四处猎巫 DHH 。与此同时,硬件价格居高不下,美国燃烧化石燃料为他们修的一座又一座数据中心供电,OpenAI、Anthropic 和 Gemini 都一个接一个地忽略基本的安全措施,把研究事故包装成「AI 太强我们已经管不住啦!」的广告神话。

说真的,我时常好奇人们是怎么平静下来的。是我的主导功能 Fi 过度发力,还是其他人对这些信息都充耳不闻?真的会有人在读完 Open Slopware 列出的 条条罪状 之后,还能心安理得地给那些不尊重创作者、肆意违反授权协议、偷窃训练数据的人送钱吗?

然而,摆在我面前的事实是:似乎是这样的,似乎大家在了解过这些不道德甚至违法2的行径后,依旧跟语言模型聊得不亦乐乎,依旧把版权状态不明的代码和文本用自己选择的授权协议发布。这些人不是随随便便的网友,而是不少我在过去以及现在都有着不少接触的人。他们甚至会为自己的行为冠以美名,比如某某模型有这样那样的问题,但另一个模型就没有,比如「LLM 让我感到自己不是在写代码,而是在创造」。

所以,我的心情很复杂。

不只是 LLM 相关,最近 NetNewsWire 的作者 Brent Simmons 也面临技术选择相关的两难。 MacStories 在八月份回到了社交媒体 X 上。X 不仅是封闭平台,还是由 Elon Musk 这号人物管理的,Simmons 表示谴责。与此同时,他意识到自己的技术选择也不是“纯洁”3的。

Do you have an iPhone? A Mac or iPad?
你有 iPhone 吗?一台 Mac 或者 iPad?

Do you order from Amazon, buy groceries from Whole Foods, or use any of their other properties (Prime Video, Twitch, Audible, etc.)? Do you use AWS or any websites that rely on AWS?
你从亚马逊买东西,从 Whole Foods 买杂货,或者用过他们的资产(Prime Video、Twitch、Audible 等)吗?你用 AWS 或者用依赖 AWS 的网站吗?

Do you use GitHub or Office or Windows or Azure or Typescript? How about DuckDuckGo, which uses Bing?
你用 GitHub 或者 Office 或者 Windows 或者 Azure 或者 Typescript 吗?那 DuckDuckGo 呢,它用的是 Bing?

Do you run Linux, which now includes AI-assisted code? Do you use Claude or ChatGPT or any of those?
你运行 Linux 吗?现在它包含 AI 辅助生成的代码了。你用 Claude 或者 ChatGPT 或者其他同类软件吗?

Do you use any Meta social networks (Facebook, Threads, Instagram)?
你用 Meta 的社交网络吗(Facebook、Threads、Instagram)?

Do you write Ruby code? (Which features DHH prominently on its home page.)
你写 Ruby 代码吗?(他们的官网上显眼地放上了 DHH 的大名)

Do you have an Android phone or use Google search or Gmail or write code in Go?
你用 Android 手机或者用 Google 搜索或者 Gmail 或者用 Go 写代码吗?

没有人的技术选择是纯洁的,许多技术的诞生或许就不纯洁。我用 iPhone、Mac 和 iPad;我虽然远离 GitHub,但大半个软件世界的基础设施都依靠 GitHub;我用 Linux,不可能不用;我写 Go 代码,我也真的非常喜欢 Go。我是法西斯主义者吗?我当然不是。

那,那些 LLM 用户就要么无知要么邪恶吗?当然不是。

These days we need all the righteous fury we can rally — and we also need the clarity to know where to focus it.

如今,我们需要我们可以聚集起的所有正当的愤怒,但同时我们也需要明晰,究竟应该把怒火集中在哪里。

“我很乖的,我听话的。”

📻

这是我第一次在周刊里提及《张春酷酷酷》这档播客节目,所以有必要简要介绍。这档节目由张春主持,每期会邀请数个素人网友连线讲述自己的故事,每期都有明确的主题。这期的主题是「我和世界的时差」。

这期一共有十一个故事,时长四小时,我挑我感想最深的两个讲。


从 02:45:22 开始的故事,我写这段文字的时候还听了一遍,再听也完全无法平静下来。一对卑鄙可耻(这个形容毫不为过)的父母,因为自己的教育缺陷和人格缺陷使得孩子不愿意和他们讲话,在打骂中孩子竟还了母亲的手,于是父亲就把女儿痛扁了一顿。这之后,孩子怎么也不说话,于是他们把孩子带到市福利院,去看那些出生畸形、没爹疼没娘爱的小孩,“教育”她要感恩。福利院里一个和孩子差不多高的小女孩走上前,机械般地念道:

“我很乖的,我听话的。我很乖的,我听话的。我很乖的,我听话的。我很乖的,我听话的。”

离开之后她终于情绪爆发,问父母什么时候把那些小孩接回来,因为父母骗她,说要去福利院接一个新的小孩。父母的说辞是,有了健康的小孩福利院会通知他们,然而孩子这时才意识到,这不过是父母的把戏。这样的把戏,她以前也见识过不止一次。见父母很快将刚才恐怖的画面抛之脑后,这个孩子思考起来:

我为什么会出生?因为这个世界上有一对夫妻,他们想要一个健康的孩子。父母爱的是他们层层筛选过的受精卵,那颗受精卵恰好是我,它也可以不是我。我也可能是福利院的孩子,福利院的孩子也可能是我。我们只能被选择,我们并无不同。生命不是天赐的礼物,生命只是计划或意外的产物,而如果失去了生命,我和这具虫尸也并无不同。我曾一度认为父母赋予我生命,他们养育我长大,我以为我天然拥有他们的爱,他们也天然接受我的自我。我总是喊“爸爸”“妈妈”,我呼唤他们,我需要他们,我爱他们,他们也爱我,因为我是他们的孩子。

什么是爱?爱是把工作的疲惫发泄在你身上吗?爱是侮辱你的朋友吗?是从不屑于了解你,只提出不切实际的要求,只要你不符合他们的想象,就否定你吗?是把你带到那些无辜而不幸的人面前,威胁你该感恩、该敬畏、该服从他们吗?可是就算是这样的爱也好,我也还是想要他们爱我的。是啊,所以你是个孩子,你要永远做这个孩子吗?你能永远忍受做这个孩子吗?他们会因为你是你而不爱你,那你会放弃自我去祈求他们的爱吗?

后来这个孩子把这件事情写在了作文里,于是得到了人生中第一张不及格的语文试卷。阅卷老师的说辞是,题材太老套,让她编也编个像样的。她觉得这个世界挺好笑的。我又不禁回忆起今年闹得沸沸扬扬的社交媒体禁令,尤其是那些带着珍珠项链的慈眉善目的白人说着要关心小孩子的面孔,想到他们说要让小孩回归球场、回归家庭的说辞,想到他们对父母的无条件信任,再看看这些故事,我也觉得这个世界挺荒诞的。

我的转述和文字是失真的,还请读者去听原来的音频。


我本想就此得出结论,说家庭不值得被信任,儿童应该得到社会的保护而不是信任家庭的保护(而很多求助渠道恰好来自网络空间),以及有些人就不配养育孩子,然后愤愤离去。后来想想,还是响应 Roger Berkowitz,拥抱多元观点吧。

从 01:32:49 开始的故事,是一个没有父亲的女孩的自述。她说自己在小时候没有意识到自己没有爸爸这件事情,对父亲这个概念很模糊,是她自己在家里乱翻东西,发现了自己父亲去世的事实,那个时候她才意识到,“原来我爸爸死了”。家里人从来不提爸爸这号人,没有他的照片,不知道父亲长什么样子。她爷爷很喜欢讲过去的事情,但提到爸爸的事情总是一句带过,从不细讲。她一直猜测爸爸是病逝或意外死亡,大家因为悲伤所以不提。

直到最近,也就是她 31 岁那年,她才从母亲的朋友口中了解到父亲的死因:父亲因杀人罪被判死刑。父亲因为投资欠了很多钱,被人追债,于是他潜入那人的家里,躲在衣柜里,之后用皮带把人勒死了。

她当时非常震惊,因为她的爷爷奶奶和姑姑都是很好的人,她自己也是个乐观向上且善良的人,她从未想过自己是个杀人犯的女儿。她印象中认为杀人犯的父母都是有问题的,但事实却不是这样。她突然把过去的各种碎片都拼凑了起来,比如奶奶为什么觉得让母亲给父亲扫墓是不该的,为什么家里人和钱的关系很远、从不碰投资,为什么爷爷说自己的是个善良的人,怎么都不会走错路。然后,她也开始心疼起周围的人,因为尽管杀人犯死了,但那些关系并不会消失,人们沉浸在悲痛中却无法诉说,因为不能缅怀一个罪人。家人们生活在这样的回忆中,却把她保护得很好,给了她一个非常幸福的童年。

这故事其实还给了我一个相当好的素材:你看看经历了这般痛苦的母亲和长辈都能养育出心理健全的小孩,你们这些仅仅是狂妄自大的父母凭什么在给自己的孩子(以及别人的孩子)造成创伤之后还能心安理得地要求孩子服从自己?

个人知识管理真的有用吗?

📜

个人知识管理(Personal Knowledge Management,后称 PKM)是近年逐渐流行起来的概念,是成体系、依赖现代化工具和的电子笔记系统。PKM 的风气大概是由 Roam Research 4 带起来的,还有 Notion 和 Obsidian 推波助澜。PKM 工具层出不穷,Loseq、Heptabase、Evernote 也占据了各自的江山,Emacs 的 Org Mode 兴许也算一个,更别提还有散落各处的或仿造 Notion 或不仿造 Notion 的笔记软件,开发者真的热衷于开发笔记软件。

PKM 体系有不少,而且有各种缩略词,比如卡片笔记(Zettelkasten)、P.A.R.A、C.O.D.E,还有 Inbox(收集箱)和 Flash note(闪念笔记)之类的概念。Brennan 对 PKM 的有效性提出了质疑,他的核心问题是:如果 PKM 真的大有帮助,那么我们不是应该在整体上看到有更多出版的书籍和论文出现吗?

事实似乎不是这样,而且 Brennan 观察到,那些 PKM 的重度用户产出的东西往往是大量的 PKM 相关内容,比如新的笔记管理概念和缩略词、笔记和任务管理技巧和各种新的方法论,而非某个具体领域的成果。还有人在一个 卡片笔记论坛 上询问,人们开始用卡片笔记法之后发生了什么改变,人们的答案似乎倾向于「更清晰的头脑和更少的焦虑感」,而非「更多工作成果」。

当然,清晰和减缓焦虑也很重要,只是目前的确没有研究证明 PKM 的兴起让生产力得到了普遍的提升(也没有证据表明它没有)。如果读者从未接触过 PKM,不必担心自己错过了什么万灵药;如果读者的确对自己的工作方式和研究方法感到不满意,从 PKM 社区学习借鉴兴许是有用的;如果读者没有什么管理方法,但仍然对自己的产出感到满意,那就不需要做出什么改变。

It’s clear that if you are somebody who already has an effective throughput, then the specifics of the underlying mechanics are uniquely personal and you should continue doing whatever works for you.

显然,如果你已经能做到有效的持续产出5,而且底层机制的具体细节是独属于你的,那你就应该继续做你觉得有用的事情。

我之前也沉迷过 PKM,我有真实数据表明6,我沉迷做笔记的那段时间,我写的文章就是更少!我 放弃 之后,文章数量和字数就开始上升了!我现在不做任何笔记,我学过东西之后就会直接上手去做;我要研究某个东西的时候会开一大堆浏览器标签页,然后直接把线索和大纲写进博客文章里,我也很少回看这些文章;我的任务管理只有一个手账本,我还经常分心涂涂画画,漏写是常有的事情,我从不信任这套体系,我会把重要的事情写在便签上贴在显眼的位置。我现在过得很好!


鸡头蛇尾

市场真的有辨别力吗?

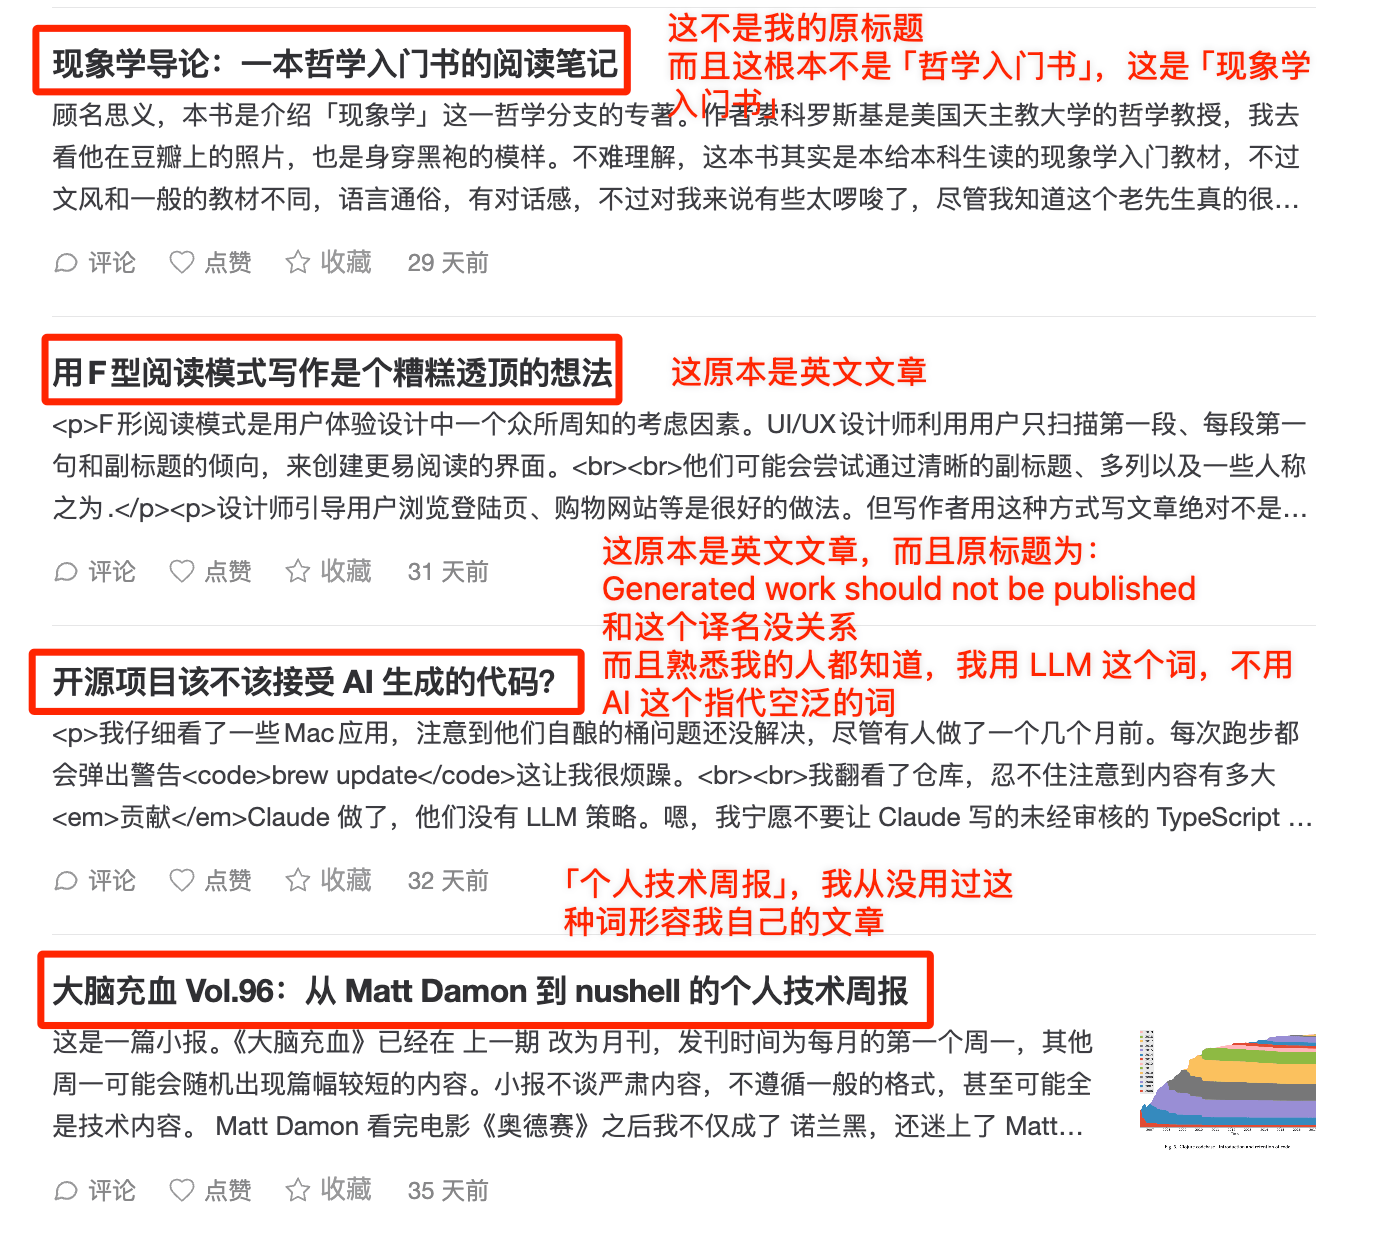
前几天我在 这条联邦宇宙串 里吐槽,某个叫 芦苇 的 Vibe-coded 应用索引了我的 RSS 源,并且用语言模型机翻了我的英文文章,乱改我的标题(顺带一提,他们的文章渲染真烂,连脚注都渲染不出来,显示成列表了)。

屏幕截图,「芦苇」应用中我的文章列表,标题都被修改过

「芦苇」应用修改过后的标题

我随便一找,就能发现他们 Web App 里的好多瑕疵:

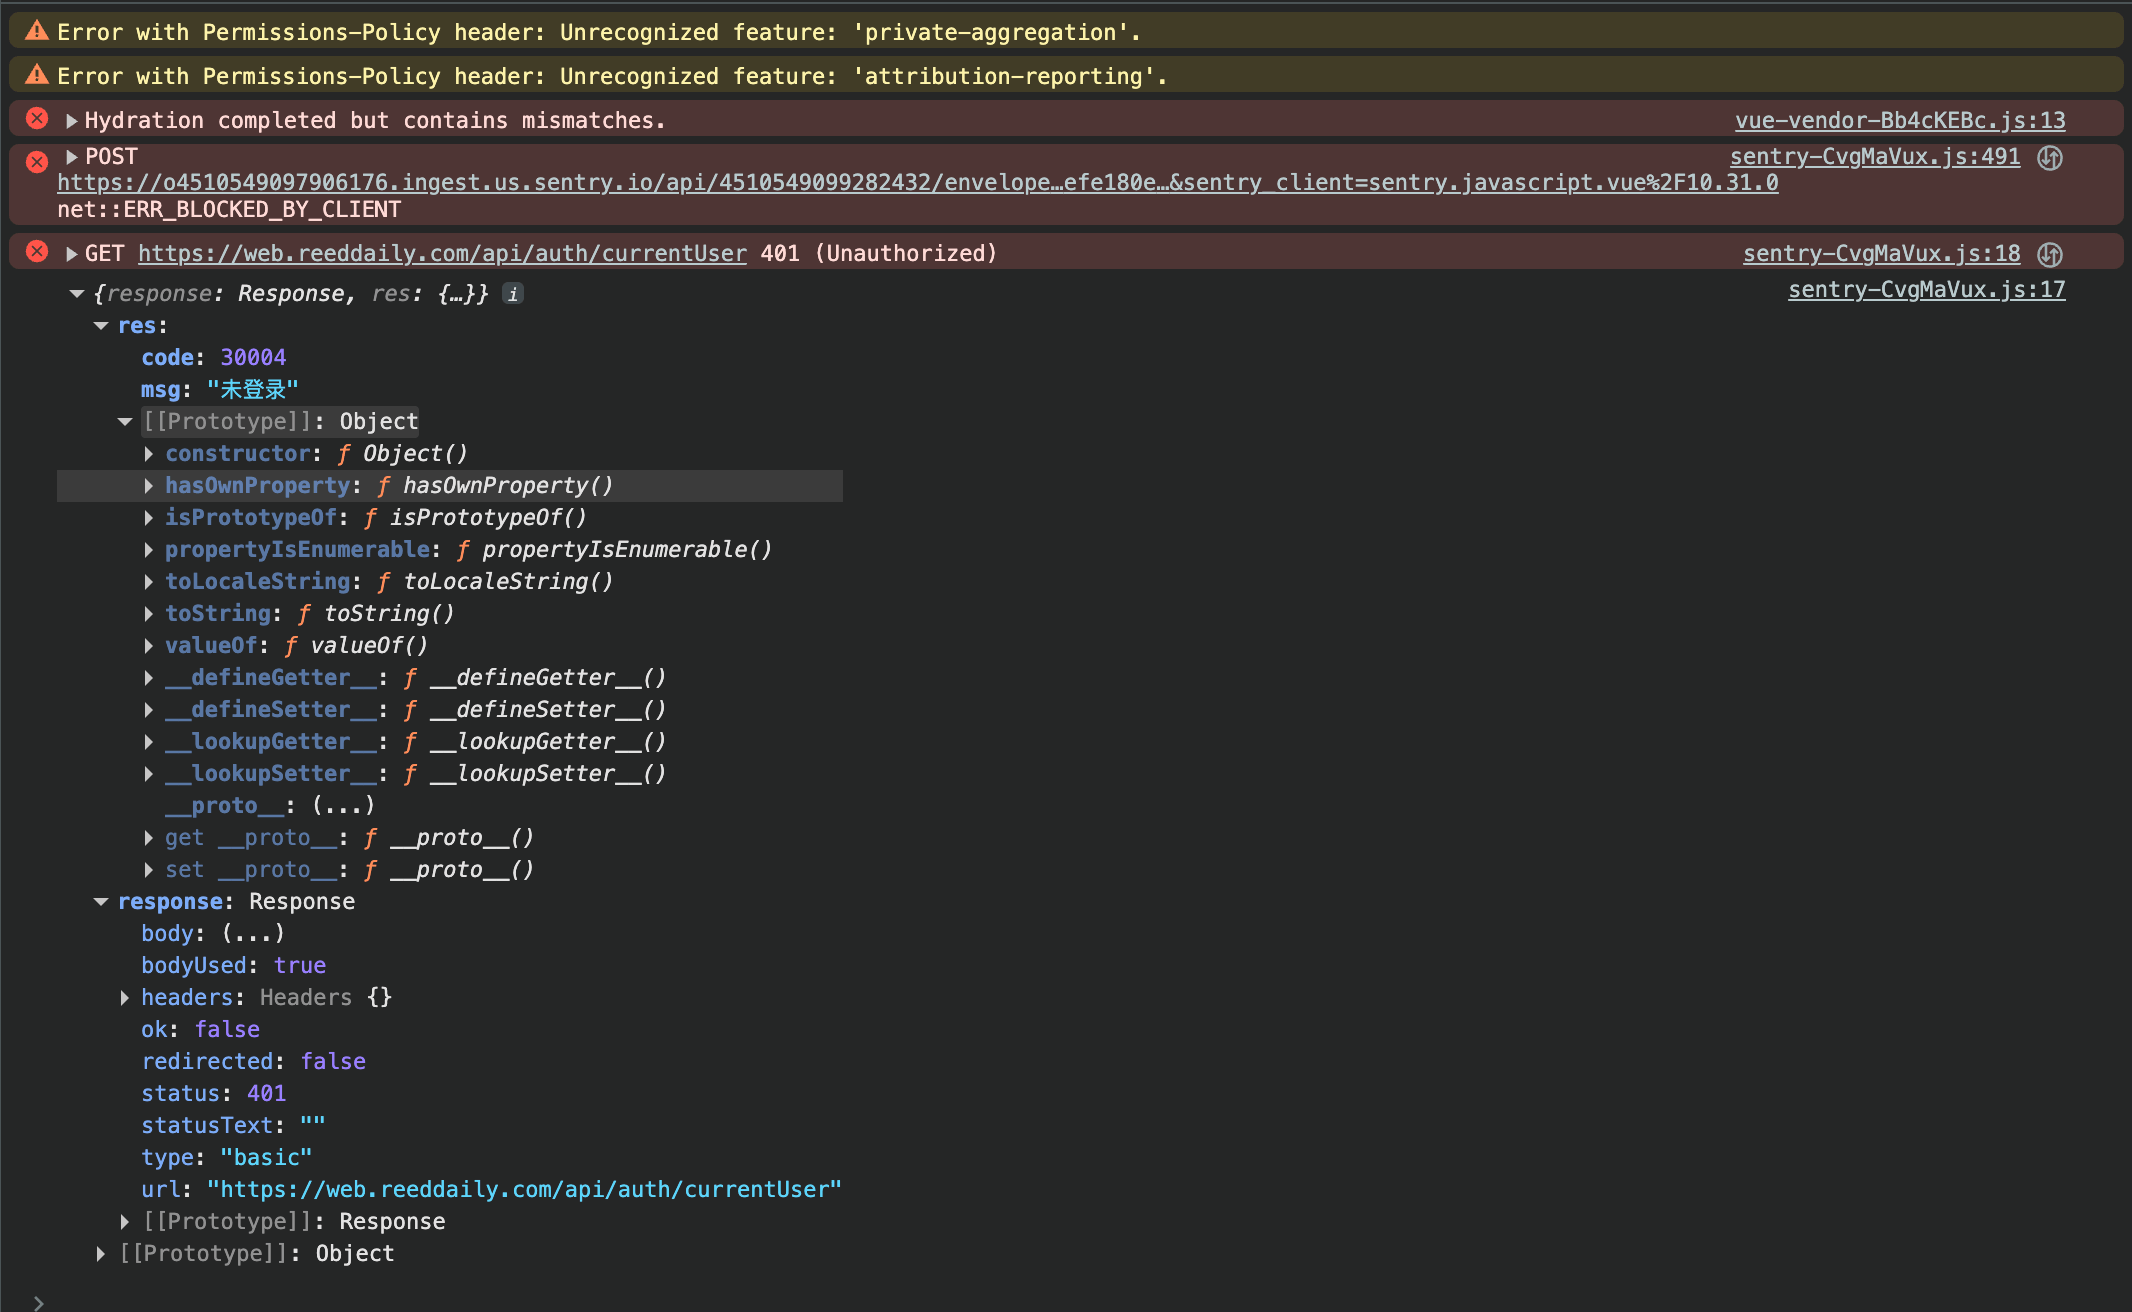
  1. 控制台输出了 API 的 401 报错和完整的 API 响应体,还有 Vue 的 Hydration 报错。他们没有做好错误处理。
    控制台输出,有很多报错,比如 Hydration error 和 401 响应
  2. 就算没有登录,还能在左下角看到本该是头像和用户名的小组件,甚至还有「退出登录」的选项。没有登录也能打开 发布内容 页面,直到点击「发布」或添加图片才会弹出登录框。结合上面错误处理的漏洞,这是完全没有考虑未登录的情况啊。
  3. 首页文章的摘要中包含 <p> <figure><img> 等未渲染的 HTML。
  4. 右侧的 关于芦苇 · 联系我们 · © 2026 芦苇 字样真的就只是文本。我真想联系他们,点了半天「联系我们」,打开审查元素才发现没有超链接,气笑了。
  5. 他们的 LLM 把 Input Token 和 Output Token 译作「输入令牌」和「输出令牌」。我怀疑这个是双关笑话,如果你没读懂这个笑话,可以读我的《 Token 应译作「符」 》。要不是我的 RSS 源只显示部分条目,我还真想看看他们会不会把这个标题翻译成《令牌应译作「符」》,不过我更好奇的是这期周刊的标题会被改成什么。

这家企业(杭州文复网络科技有限公司,浙 ICP 备 2025150892 号-2)显然违规了。我的内容以 CC BY-SA 4.0 协议发布,任何人都可以自由使用和演绎,但前提是:

You must give appropriate credit, provide a link to the license, and indicate if changes were made.

你必须给出恰当的署名,提供协议的链接,并且指出有没有修改作品。

他们给了署名,但没有标注 CC BY-SA 4.0 协议的链接,这是第一条违规;他们用语言模型修改了我的标题,但没有指出他们做的修改,这是第二条违规。

If you remix, transform, or build upon the material, you must distribute your contributions under the same license as the original.

如果你混合、修改或基于这个材料创作,你必须用和原作同样的协议分发你的贡献。

他们并没有以 CC BY-SA 4.0 协议发布修改后的版本,而且根本没有标注内容使用协议。这家公司的法务在做什么?你们的使用条款呢?(我试图在登录界面点击使用条款和隐私政策,竟然被重定向到了首页)页面里只写了 © 2026 芦苇,我可以合理认为你们的意思是说,你们修改之后的内容,版权归属于你们。

不拿语言模型乱改我的内容,就不会有这些问题。我觉得更好笑的是,这个以 “AI” 功能为卖点,还大量使用模型乱改和机翻原作者内容的产品,竟然索引了著名 “AI” 批评者 Ed Zitron 的文章,还放到了他们 App Store 页面的宣传图里。

尽管搞笑,但我也感到荒谬。这样的产品,从首页的点赞数来看,竟然有不少用户,而且 App Store 的评分有 4.8。从评价来看,大家似乎很喜欢这个产品。我不禁怀疑,市场真的有辨别力吗?

国庆在饭桌上,我旁观了我表哥和他父亲的对话。他们在聊金融和投资,争论 Intel 和 AMD 哪家芯片厂商更值得投资。我姑父一直强调 Intel 的芯片和指令集更具有优势,我能听出来他对硬件的技术细节是有了解的,不过我表哥一直强调云服务器大量使用 AMD 的芯片,市场份额比 Intel 高,难道能说市场是错的吗?他们最终没能达成一致。我听完的感受是,他们两个说的都是对的,但市场的确不代表真理。Intel 可能有诸多优势,但不代表市场就会选择它。同样,那个粗制滥造且违法违规的 App 仍会因为各种奇怪的原因(比方说产品宣发)而获得市场青睐,但改变不了那背后不过是一群投机者,对软件和文字都毫无尊重的事实。

金融行业或许应该看市场走向,但对个人而言,永远不要听信人群里喊得最大声的那群人。他们不仅不一定是对的,而且往往是错的。

WebAssembly in Anubis

📜

基于 PoW7 的网站防火墙 Anubis 终于在花了一年时间后支持了 WebAssembly。用 WASM 是出于性能考量,WebAssembly 是编译好的、可以在浏览器和服务器等多种环境运行的二进制文件,要比浏览器解释 JavaScript 代码快很多,性能也有很多优化空间。

Anubis 长期面临的问题是手机等电子设备的 CPU 太差,运行难度稍微高一点的 PoW 运算就会卡顿发烫,但又不能给手机用户直接降低难度,因为爬虫可能会把自己伪装成手机。按特征分类需要很谨慎才不会留下漏洞,然而 Anubis 又是开源的,不能指望爬虫不会发现线索。

使用 WebAssembly 可以在一定程度上解决性能问题,也能让 Anubis 的速度变快,毕竟没有用户想要被拦住太久。他们还顺带解决了 PoW 难度的 升阶问题 。

给 Anubis 加上 WebAssembly 比其他应用难很多,因为 Anubis 需要兼容非常老的浏览器版本和机型,不然就会把用老机器的用户拦截在外。这段一般的 Web 应用来说问题不大,但 Anubis 的初衷就是拦截 “AI” 爬虫,保证能访问网站的都是真人,向后兼容性对开放的万维网很重要。他们在 这一年的过程 中踩了不少坑,甚至还发现了(Xe Iaso 本人职业生涯中第一个)LLVM 编译器的 Bug,可以说从设计、实现、测试到编译,都因 Anubis 的特殊性遇到了很多难题。

我之前给自己的 Forgejo 实例 安装过 Anubis,其实拦截很有效,不过我不觉得自己的网站会承受那么多爬虫的流量(尽管它们确实非常非常多),拦截验证自己本就不多的访客似乎不太好。于是我在后来换成了简单的 Cookie 验证。如果有任何人需要的话,Anubis 其实相当不错,可见其主要维护者是在用心做软件的——不过他们其实也在用 Agent 开发 Anubis,这可真是让我…… 心情复杂。

尽管不用 Anubis,我最近确实在考虑安装 Iocaine。我也在 Tim McCormack 的博客上读到一篇 好玩的文章 ,他用 Rust 实现了 断联通讯社算法 8,可以把文字替换成看着像真文本但实际读起来没有任何意义的内容。我有点想设计并实现中文版本的非联社通讯社,把用算法扭曲过的内容喂给不守规矩的爬虫。

现代化开源桌面端

ℹ️

LWM(Linux Weekly News)报道了 Scott Jenson 在 KDE 的年度会谈上的讲话。Jenson 在 Apple 和 Google 都有做 UI/UX 设计师的经验。如果读者也接触过 Linux 桌面端或者别的开源桌面软件,会发现自由和开源的桌面端软件中很难找到 UI/UX 设计精良的。Jenson 想要「现代化」开源桌面端。

Jenson 表示开源桌面端的一大问题是,他们在过去一直跟随 Windows 和 macOS 的设计,但事到如今,这些操作系统背后的公司其实也有些摆烂了,他们不再稳定产出值得参考的 UX 设计。我仔细回忆了一下最近 Microsoft 和 Apple 在桌面端做了些什么,我只能想到: Windows 现在才在快照版本的 File Explorer 里支持 ~ ,他们在 Windows 11 才支持 sudo(并且我自己体验下来觉得很难用),还有刚过去不久的 macOS Tahoe 的丑陋 UI 设计和噩梦般的性能消耗(Golden Gate 要好很多的,但依旧没有好的创新)。

总之,Jenson 的意思是说,我们(开源社区)应该把领导权放到自己身上。说实话我也挺期待有越来越多优秀的 UI/UX 设计师在开源社区涌现,让开源桌面端反过来变成商业桌面端的参考对象。

Jenson 还提到了大语言模型,他本来不想谈却又不得不提。他的原话是这样的:

I have to talk about AI, and it pisses me off because there’s so many cool things we could be talking about, and AI just sucks up all the oxygen, and it’s all you can talk about.

我不得不提到 AI,我很生气,因为我们明明有很多很酷的事情可以讨论,但 AI 占据了所有的氧气,你能谈的就只有 AI 了。

我深有同感!我记得我之前还抱怨过此事,得到的回应竟然是:技术社区允许讨论技术之外的东西吗?真是令人唏嘘,人们似乎下意识地觉得除了语言模型之外再无其他可以讨论的技术,觉得语言模型就是人工智能这一概念的全部。

Jenson 说在 Claude Code 以前,人们都在原有的应用里乱塞 LLM,直到 Claude Code 推出了新的 UI/UX 设计(然后一大堆同类的 Agent 就涌现了……),他认为我们可以有更多这样的设计。不过他有提及,他自己也痛恨大模型公司做的那些事情,不过随着 Apertus AI 9 的出现,他看到了合法合规合乎道德的语言模型的可能性,未来兴许这样的模型会改变桌面端。

又一件令人唏嘘的事情,火起来的是 Jev 而不是 Apertus。不意外,市场当然偏好更易用的 Typed LLM,而不是致力于合法合规的 Ethical LM。

Jenson 认为开源用户也是在意 UI/UX 体验的。他记得之前向 KDE 提过一个功能,在 macOS 上,在窗口之间拖拽元素时,在鼠标释放之前,被拖拽元素所在的窗口都不会升起来(raised),也就是不会突然挡住要拖过去的那个窗口。窗口是在鼠标释放之后才升起来的。之前 KDE 不是这样,他提出之后,这个功能很快就被一个贡献者实现了。

我其实很想给开源桌面端贡献,不过我确实没有什么桌面端开发的经验。我做桌面端的话,大概只会用网页套壳(当然不会用 Electron,大概会用 Tauri 或者 Wails),而且也没什么点子。兴许我可以去了解 Qt 之类的框架。

函数式编程让复杂系统更容易构建

📜

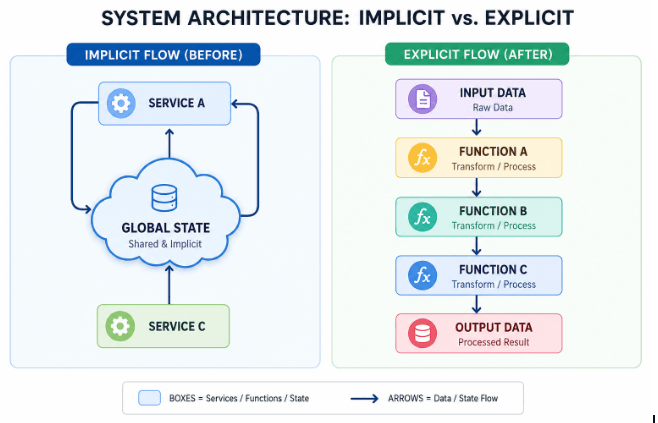
这大概率是一篇用于优化网站 SEO,持续给网站产出内容进行引流的文章,换句话说,类似国内的“营销号”。不过也出于其营销性质,文章简单易读。配图虽然有脱裤子放屁之嫌,但还算能看。本文讲解函数式编程范式和高阶函数(High-order function)如何让复杂系统更容易构建和维护,与传统的以数据为中心的面向对象编程做了对比。

文章的主要观点是,函数式系统的数据流向非常清晰,由一个函数流向下一个函数,没有共享的可变状态。在传统的系统里,往往需要维护各种状态,同一块数据有多个写者读者,很难知道是谁修改了数据,数据流很容易变得混乱。

隐式数据流和显式数据流的对比图,来自 原文

在面向对象的系统里,对象不仅保存了不可见的内部状态,还定义了一系列方法。随着需求增加,越来越多的方法和复杂度会被添加到同一个对象内部。函数式系统由小巧的函数组成,不和对象绑定,天然地容易践行开闭原则(Open-close principle),即对拓展开放,对修改封闭。函数可以很轻易地组合复用,不需要修改函数内部的结构。我想到了面向对象设计中的装饰器模式(decorator pattern),用一个对象包装另一个对象,拓展其功能,其实,只需要用一个函数调用另一个函数就能实现装饰器。

纯函数不维护内部状态,只是接收参数,所以每个函数都是独立的,每个函数都能被测试。如果要测试一个对象,需要先实例化对象,这可能还需要实例化其他的对象,传给这个对象的构造方法才行,复杂的业务逻辑经常需要这么干。测试函数就不一样了,可以轻易地传入假的测试数据,函数的返回值也清晰且可预测,测试断言写起来也容易。

为了方便函数的组合复用,高阶函数往往很有用。这是文中给的例子,process-transaction 是个高阶函数,或者说 Fold 。

(defn process-transaction [transaction calculate-fee]
 (let [fee (calculate-fee (:amount transaction))]
 (assoc transaction :fee fee)))

(def payment
 (process-transaction {:amount 100} #(* % 0.02)))

(def refund
 (process-transaction {:amount 100} #(* % 0.01)))

第一个参数为操作对象,余下的参数则是要对操作对象做的变换。高阶函数很方便复用,可以组合起来操作同一个数据对象。

(-> {:amount 100}
 (process-transaction #(* % 0.02)
 (process-transaction #(* % 0.01)))

上面这个例子中的 transaction 是个映射(map),Clojure 的数据管线常常需要传递各种映射,修改其中的值或者增加新值,然后返回,传递给下一个函数。我一般是用箭头宏 -> 写数据管线的,这篇文章让我学到了新写法,用返回函数的函数构造管线函数:

(defn pipe [& functions]
 (fn [value]
 (reduce (fn [result fn*] (fn* result)) value functions)))

(def process-data
 (pipe validate transform save))

(process-data input)

这样一来,管线就是数据驱动(data-driven)的,可以随意修改传给 pipe 的函数数量和顺序,就像操作数据一样修改管线的结构,而不是写死成函数调用。

怂货式编程

📜

Ivan Grishaev 观察到一种很常见的 Clojure 编程模式:

(defn double-number [x]
 (when x
 (* x 2)))

;; or

(defn get-user [id]
 (when id
 (jdbc/execute! *db* ["select..." id])))

简单来说,人们喜欢在函数定义里套一层 when,确保参数不是 nil(空值)才执行代码。如果参数是 nil,函数的返回值也会变成 nil,程序不会崩溃也不会有任何报错。这看起来少了很多麻烦,程序不会动不动就崩溃了。Grishaev 把这种编程模式称作「怂货式」(coward style)。

这么做仅仅是让问题更难定位了。Clojure 代码里经常出现较长的执行管线,数据从一个函数传递给下一个函数,函数链中有一个函数返回了 nil,整个链路的结果都会变成 nil,而中间不会有人和函数报错,只能一个个排查。

Grishaev 认为,如果即将传给函数的参数是 nil,那这个函数根本不该被执行。Clojure 里已经有 some-> 宏可以做到这点了,在管线里有任何返回值是 nil,some-> 就不会调用下一个函数。

(some-> (get-user-id) (get-user))
;; 如果 get-urser-id 返回 nil,get-user 不会被调用

说实话我是读了这篇文章才第一次知道 some-> 这个函数,Clojure 标准库里的函数不少,常用的就几个,要全部了解应该很难。

不仅不应该避免函数报错,反而应该更多地报错,给出明确的报错,这样才能排查问题。Clojure 是动态类型语言,很少有类型报错。可以用 Pre-condition 和 Post-condition 约束函数的输入输出类型,本质上是一系列谓词函数,在调用函数之前用 :pre 谓词函数检查参数是否符合要求,返回值之前用 :post 检查输出是否正确。如果有返回 false 的,就报 AssertionError。

(defn double-number [x]
 {:pre [(number? x)]}
 (* x 2))

函数内部还可以用 assert 断言类型。在大部分编程语言里,断言是用于测试的,不该在生成环境中报断言错误。所以在构建时可以把全局变量 *assert* 设为 nil,这样就不会执行断言。

Clojure 还有 clojure.spec 库,用来定义更复杂的数据规格(Spec),可以检查和断言数据是否合规,与 Pre/post-condition 组合使用最佳。

我最近在写 weepinbell 的时候也遇到了不少类型问题带来的麻烦,一部分原因是我或多或少也应用了怂货式编程,另一部分原因是测试覆盖不完全,或许还有一部分原因是动态类型语言需要比静态类型语言更多的自律。我也开始怀疑,是不是选用静态类型的 Haskell 或 TypedClojure 会更好。


漫步遐思

  • 想在引擎呜呜作响的高空阅读 Wuthering Heights(《啸风山庄》),结果起飞前后的播报就没停过,平稳起飞之后乘务员开始带货(真惨,乘务员也要做销售)。终于安静下来的时候,我的脑子已经很累了。

  • 落地机场之前看到重庆的夜景,头一次升起思乡之情。不过我不念家, 一点也不念家 。下飞机之后在机场迷路了,这才想起这是 8D 魔幻城市,机场出口有三层地面,我说真的。

  • 时常下意识认为对方是能交流的理智人,结果我抛出对方不同意的观点之后收到的不是令人信服的反驳,而是一个笑哭的表情、「不是哥们」「XXX 出来也没通知我啊」「XXX 可能 YYY,但 XXX 会 YYY 不太可能」…… 不过我面对此情此景,脑子里冒出来的竟然是 Papi 酱的「Oh my god. 你吓到~ 我了~」,我大概也得换个脑子了。

  • 剧本杀店的 DM10 和演员大概都喜欢挑胆小的吓,我一个朋友刚进门就问 DM 说能不能不要吓她。结果在第一次搜证的时候,只有她一个人被 NPC 追了。其实那场景真挺吓人,是一个完全没有灯的 L 型走廊,要走进去说词,祭拜鬼神,然后从没有灯的路走回来。她尖叫着跑出来的时候,我才知道人是真的能被吓哭的,至少对我来说,恐惧很少和眼泪联系起来。

    后面还有团体搜证,五个人抱团进小黑屋,举着发绿光的电子蜡烛找线索卡。中途有个戴面具穿黑衣的演员时不时从各个角落探出头来大吼一声。说实话,能看清楚脸就不觉得吓人了,而且那小黑屋的结构挺简单的。

  • 去姑姑家吃饭,屋里多了一只见人就想要扑上来打招呼的泰迪犬。后来才知道那是我爸买的,他嫌弃这狗黏人,又摔又打又骂,还好我姑把它收走了。

    两三天后我又去他们家吃饭,我看见我爸骂它,还有它想要接近却在看清楚是谁之后绕着走的样子,感到不平。我没说话,又听起我爸有说有笑地讲起他有好几天都是喝醉的,稀里糊涂地没想起喂鸟,把家里一只鹦鹉饿死了。那只鹦鹉也很亲人,在我肩膀上站过,碧绿色的羽毛很好看。

    饭后大家都很吵,狗狗趴在门口的地板上。我把它招呼过来,我抚摸他的毛发,它想要舔我的手,我就让它舔。它费力地站在地上,把前爪放在我的腿上,瞪大眼睛看着我。后来我让它到沙发上来,一会儿它就把头倚在我的腿上,眯着眼睛睡了。我一边抚摸它,一边观察它的呼吸,原来泰迪可以很安静。后来我姑姑出门丢垃圾,它就从我身上下来,守在门口等她回来。门口有人经过的时候它总是叫,姑父很不喜欢。可我知道,它是想要保护这个家啊。


  1. 而且,如果去这期新播客的评论区看的话,会发现没有人讨论内容本身。有人喜出望外地发表仲树重新更新的感想,有人继续质问和谩骂,有人扮演起“理中客”,开始统计“无脑粉”和“黑子”的“票数”。 ↩︎

  2. 单论 Anthropic,他们就有好几场 官司 没打完。 ↩︎

  3. 这里原文用的是 free of fascists(没有法西斯主义者),西方媒体滥用法西斯一词已成习惯,Simmons 作为个人也受了这种媒体习惯的影响。大体上,他所说的 fascists 可以理解为中文语境中的「资本」「极右分子」之类的词。 ↩︎

  4. 顺带一提,Roam Research 是用 Clojure 写的;后文提及的 Logseq 也是用 Clojure 写的。 ↩︎

  5. 译注:原文 throughput 意为「吞吐量」,表示在一定时间内的工作产出量。这里为了通顺,译作「持续产出」。 ↩︎

  6. 见博客的 洞察 页面,里面有每月的文章字数统计。 ↩︎

  7. Proof of Work,工作量证明,即要求客户机计算一段无意义的复杂运算,服务端得到正确答案之后放行。这能拦住一部分爬虫,同时也使得爬虫爬取网站的成本变高,因为 PoW 会消耗大量 CPU 时间。 ↩︎

  8. 译注:原文 Dissociated press,我没有找到译名。这个词本来是对 Associated press(联合通讯社;美联社)的戏仿,所以我依照这层意思译作「断联通讯社」。我也想过「丑联社」这个译名。 ↩︎

  9. Apertus 是完全开放权重、开放训练数据、开放文档,任何人都可以复现的小语言模型。 ↩︎

  10. Dungeon Master,地下城主。这个词原本来自桌游《龙与地下城》。 ↩︎

Coffee Break Clojure, Namespace

在 第一篇 我们安装了 Leiningen,当时只是用它启动了 REPL 和 nREPL 服务器,现在我们要用它来干点重活儿了。顺带一提,Leiningen 的名字取自短篇故事《 莱宁根大战蚂蚁 》,故事情节…… 就是一个叫莱宁根的男人大战蚂蚁。

创建项目

在终端输入 lein new -h 命令查看帮助,可以看到这些模板:

Subtasks available:
template A meta-template for 'lein new' templates.
plugin A leiningen plugin project template.
default A general project template for libraries.
app An application project template.

模板只是提供了预先配置好的项目描述文件和项目结构,选哪个都不影响开发。简单来说,如果要写个 Clojure 库就用 default,如果要写应用程序就用 app。下文用 app 做示范。

创建一个名叫 antfighter 的应用。

lein new app antfighter
cd antfighter
❯ tree
.
├── CHANGELOG.md
├── doc
│   └── intro.md
├── LICENSE
├── project.clj
├── README.md
├── resources
├── src
│   └── antfighter
│   └── core.clj
└── test
 └── antfighter
 └── core_test.clj

7 directories, 7 files

项目默认生成的 LICENSE 是 Eclipse Public License ,和 Clojure 一样。如果是写着玩儿的应用,可以直接删掉;如果要发布的话,建议考虑更换授权协议。

除了 .md 文档,剩下的目录就和典型的 Java 项目非常像了。

  • src/:源代码,其中每一个目录下的文件都对应一个 Clojure 命名空间
  • test/:测试代码,可以用 lein test 执行里面的测试
  • resources/:代码使用的静态资源,包括 Web 资源,也可以是嵌入到软件里的其他程序,比如编译好的 WebAssembly

说实话,我觉得这是 Clojure 从 Java 那里学来的陋习,不如 Go 的 标准布局 。src/ 目录只能让项目的最外层看起来整洁。除非是包含多个项目的 Monorepo,否则我不觉得 src/ 这类目录有存在的必要。

值得注意的是 project.clj,这是项目描述文件:

(defproject antfighter "0.1.0-SNAPSHOT"
 :description "FIXME: write description"
 :url "https://example.com/FIXME"
 :license {:name "EPL-2.0 OR GPL-2.0-or-later WITH Classpath-exception-2.0"
 :url "https://www.eclipse.org/legal/epl-2.0/"}
 :dependencies [[org.clojure/clojure "1.12.2"]]
 :main ^:skip-aot antfighter.core
 :target-path "target/%s"
 :profiles {:uberjar {:aot :all
 :jvm-opts ["-Dclojure.compiler.direct-linking=true"]}})

defproject 的第一个参数是项目名,第二个参数是版本号,SNAPSHOT 表示快照,正式发布时改成自己习惯的命名就好,比如 Semantic Versioning 。

余下的是可变长度的参数,要求是偶数个且以键值对的形式出现,就是映射的结构。除去 :description、:url 和 :license 这些顾名思义的选项,上述选项的意思分别是:

  • :dependencies:依赖项,应该是包含所有依赖声明的向量。向量的元素通常是长度为 2 的向量,第一个元素是依赖名,第二个元素是版本号。默认都应该加载 org.clojure/clojure 依赖项。
  • :main:项目的入口,即运行项目时应该在哪个命名空间里找 -main 函数。
  • :target-path:和 Java 一样,target 就是编译产物存放的目录。
  • :profiles:可以为不同的运行环境和命令指定选项、参数和依赖项。
    • :uberjar:Uberjar 也叫 Fat Jar。Clojure 和 Java 一样,最终编译为 .jar 文件,而 Uberjar 就是把所有依赖项都打包在内,可以独立运行的 .jar。这个 Profile 是执行 lein uberjar 编译命令时会用到的参数。

更多的选项会在后文提及,也可以查看官方提供的 sample.project.clj 。

命名空间与符号

之前我们简单略过了命名空间(namespace)的概念,可以理解为符号(symbol)的集合,一个命名空间下的符号不能有重合,命名空间可以相互引用对方的符号。

在 Clojure 里,用 ns 进入一个命名空间1。如果你在 REPL 里想要直接访问某个命名空间里的符号,可以输入 (ns project.namespace);在文件开头写 ns,就可以在这个命名空间里定义符号。

ns 的第一个参数是命名空间的名字,与当前文档在 src/ 的子目录对应。比如,如果文件被放在 src/antfighter/core.clj,这个文件的命名空间只能叫 antfighter.core。子目录同理,src/antfighter/http/client.clj 是 antfighter.http.client。Clojure 文件不应该包含 -,而是用 _,但是在命名空间的命名里要变成 -,比如 src/antfighter/meat_proxy.clj 应该是 antfighter.meat-proxy。

以下是我们刚才生成的示例代码中的 core.clj 文件:

(ns antfighter.core
 (:gen-class))

(defn -main
 "I don't do a whole lot ... yet."
 [& args]
 (println "Hello, World!"))

这个文件的 ns 还包含更多的参数,写在 ns 内部的 :gen-class 等价于直接写 gen-class。同理还有 :require 和 :import,之后会谈到。

(ns antfighter.core)
(gen-class)

gen-class 的作用是生成 Java 类(Generate Class)。如果你需要把 Clojure 程序编译成 JVM 字节码(.jar 文件),然后直接在 Java 环境里执行,就需要给主命名空间生成 Java 类。其他命名空间是通过 Clojure 调用的,只有 core.clj 才需要 Java 类。

如果直接用 clj 或 lein 命令行,就自带 Clojure 运行环境,不需要 gen-class。

继续,看刚才一同生成的 core_test.clj,可以注意到 test/ 目录下的文件也对应一个命名空间,test/antfighter/core_test.clj 对应 antfighter.core-test。稍后再来看测试怎么写。

(ns antfighter.core-test
 (:require [clojure.test :refer :all]
 [antfighter.core :refer :all]))

(deftest a-test
 (testing "FIXME, I fail."
 (is (= 0 1))))

此外还有 :require,用于引入另一个命名空间的符号。require 接收可变数量的参数,每个参数都是一个向量:第一个元素是命名空间名,第二元素是 :refer 或 :as,第三个元素根据第二个元素而定。向量也可以只有一个元素。

  • [project.namespace]
    • 可以在当前命名空间使用 project.namespace 中的符号。假设 project.namespace 中有 say 符号,可以用 project.namespace/say 引用。
  • [project.namespace :as pn]
    • 可以在当前命名空间用 pn 作为 project.namespace 的别名。
    • 例如,project.namespace/say 可以写作 pn/say。
  • [project.namespace :refer [symbol]]
    • 可以在当前命名空间中直接使用 project.namespace 中的 symbol,不需要写 / 以及命名空间的名字。
    • 可以在 :refer 之后的向量中填写多个符号名。
    • 可以把 :refer 之后的向量替换成 :all,把命名空间中的所有符号引入当前命名空间。不推荐这种写法,需要注意命名冲突。

其实还有 :use 的写法,等同于 :require [... :refer :all]。:use 也可以加上 :exclude(排除)和 :only(只引入)等参数,但根据 Clojure Style Guide 的 讨论 ,现在已经不推荐使用 :use,全部换成 :require 是最好的。

至于 :import,这是用来引入 Java 库的,这个我们留到之后讲 Clojure 如何与 Java 联动的时候再说。

引入依赖

Clojure 有多种声明依赖的方式,被原生支持的是 deps.edn,写法如下:

{:deps {org.clojure/clojure {:mvn/version "1.10.3"}}
 ;; ...
 }

不过我们在用 Leiningen,所以可以直接在 project.clj 里声明:

(defproject antfighter "0.1.0-SNAPSHOT"
 :dependencies [[org.clojure/clojure "1.12.2"]]
 ;; ...
 )

Leiningen 的写法干净不少。Leiningen 和 deps.edn 都默认用 Maven Central 和 Clojars 作为依赖的来源。Clojars 是个专门用来发布和存放 Clojure 依赖的 Maven 仓库 ,与 Maven 相关的工具兼容。不过我们用的是 Leiningen,不需要考虑太多细节。

假设我们要解析 JSON,需要引入 Cheshire 库2。可以先去这个仓库的 README 里找到依赖字符串 [cheshire "6.2.0"],然后复制到 project.clj 里。也可以直接在 Clojars 上直接搜索依赖。

(defproject antfighter "0.1.0-SNAPSHOT"
 :dependencies [[org.clojure/clojure "1.12.2"]
 [cheshire "6.2.0"]]
 ;; ...
 )

保存之后执行 lein deps 可以下载依赖。用 lein repl 启动 REPL,或者用 lein run 运行程序的时候也会自动下载依赖。如果添加了新的依赖,就要重启 REPL 或者重启应用,否则不会生效。

写个文件测试一下,把 Clojure 数据转换为 JSON 字符串,再把字符串转换为 Clojure 数据试试。

(ns antfighter.cat
 (:require [cheshire.core :refer [generate-string parse-string]]))

(generate-string {:foo "bar" :key "val"}) 
;; => "{\"foo\":\"bar\",\"key\":\"val\"}"

(parse-string "{\"foo\":\"bar\",\"key\":\"val\"}") 
;; => {"foo" "bar", "key" "val"}

好了,现在你已经会导包了,可以说已经跨进 Clojure 生态的大门了。如果想知道某个外部命名空间里有哪些符号,可以阅读对应的文档,或者翻阅源代码。

偷渡 Java 代码

Clojure 毕竟是门 Lisp,用的人相对较少,所以有时候会找不到想要的包。这时就可以从生态更成熟的 Java 那边偷来用。

还记得 Leiningen 也从 Maven Central 拉取依赖吗?Java 的各种 .jar 就放在 Maven Central 上,所以可以直接拿来用。

比方说,我想用 Apache Commons Validator (用于检验数据有效性的库,比如 URL 是否合法),将依赖名和版本号写进 project.clj 即可。格式上,Java 的依赖和 Clojure 的依赖没有什么区别,它们实际上也都只是 .jar 文件而已。

(defproject antfighter "0.1.0-SNAPSHOT"
 :dependencies [[org.clojure/clojure "1.12.2"]
 [cheshire "6.2.0"]
 [commons-validator "1.11.0"]]
 ;; ...
 )

Clojure 的 import 跟 Java 的差不了太多,import 的参数是 Java 的包名加上类名。比方说,刚才的 Apache Commons Validator 可以这么用:

(ns antfighter.spider
 (:import [org.apache.commons.validator.routines UrlValidator]))

(defn valid-http-url? [url]
 (let [schemes (into-array String ["http" "https"])
 validator (UrlValidator. schemes)]
 (.isValid validator url)))

import 和 require 类似,也可以接收多个向量。每个向量的第一个元素是包名,后面的是可变数量的元素,是 Java 类名。上述代码从 org.apache.commons.validator.routines 这个包3里引用了 UrlValidator 类。

顺带一提,Clojure 做的一大改变就是把类和命名空间解耦了。在 Java 中,类既是数据类型,又是命名空间。Clojure 的创造者 Rich Hickey 在演讲《 Simple Made Easy 》中就提到了这一点。Clojure 的命名空间就只是命名空间而已。

除了在 project.clj 里声明的外部 Java 库,也可以直接用 Java 标准库里的类。

(import [java.net URI URL])
;; 上述代码引入了 java.net 的包 
;; 里的 URI 和 URL 类

你可能注意到了,我们引入的是 Java 类,不是 Clojure 符号,处理起来会有点困难。Clojure 提供了点语法。. 是 Clojure 的特殊形式,和 Java 的 . 类似。

import java.util.Date

Date date = new Date()
date.getMonth()

上述 Java 代码相当于:

(import [java.util Date])

(def date (new Date))
(. date getMonth)

上述 Clojure 代码还可以进一步简写:

(import [java.util Date])

(def date (Date.))
(.getMonth (Date.))

new Object 相当于 Object.,这是 Clojure 提供的语法糖。如果要用点语法调用对象的方法,可以在方法名前面加上 .,当成函数来用,函数的第一个参数就是对象本身,像这样:(.method object args...)。

还可以进一步简写:

(.getMonth (java.util.Date.))
;; => 10

如果你熟悉 Java,你应该知道除了必须把类实例化为对象才能调用的方法,还有静态方法。静态方法可以直接在类上调用,不需要创建对象。对于静态方法,只需要把 Java 类当成 Clojure 命名空间,把方法当作命名空间里的函数,也就是用 / 语法。

(java.time.Instant/now)
;; => #object[java.time.Instant 0x1c2b8e81 "2026-10-02T16:26:17.401045Z"]

好了,现在你已经会偷 Java 代码用了。

在 Clojure 中写 Java,本质上是同时使用 Lisp 的语法和 Java 的语义(semantics),类的概念都来自 Java,和 Clojure 格格不入。所以,除非必要不建议大量使用 Java 库,如果要用,也建议把 Java 代码封装在 Clojure 函数里。其实不少 Clojure 库就是通过封装 Java 库开发的,有些 Clojure 库还会专门用 Java 写,这样性能会更好。4

开发依赖和 Leiningen 插件

之前引入的依赖都是代码依赖,会被一起打包到 Uberjar 里。还有一类依赖是开发依赖,比如测试工具、代码格式化工具、Mock 工具、依赖管理工具等等。

还记得 project.clj 里的 :profiles 吗?其实每个 :profiles 都可以声明自己的依赖项。比如说 :test 就针对 lein test,只有在运行测试时才会加载里面声明的依赖。下面的代码引用了 ring-mock,这是用来测试 Ring 项目的 Mock 工具。5

 :profiles {:uberjar {:aot :all}
 :test {:dependencies [[ring/ring-mock "0.6.2"]]}}

上述依赖不写在 :profiles 里也能用,但运行和编译代码时,都会把实际上并没有在生产代码里用到的依赖打包进去,会消耗额外的资源,因此应该分离。

此外还有 Leiningen 插件,插件和代码以及测试代码都没有关系,而是用来辅助开发的,写在 :plugins 设置项里,格式与依赖相同。下面是我常用的一些插件。

 :plugins [[lein-ancient "0.6.15"]
 [lein-ring "0.12.6"]
 [lein-cloverage "1.2.2"] 
 [dev.weavejester/lein-cljfmt "0.16.5"]]
  • lein-ancient :可以运行 lein ancient 命令检查依赖是否有新版本。
  • lein-ring :可以用 lein ring 运行基于 Ring 的 Web 服务,支持热重载,而且不需要在代码里编写运行服务器的逻辑,也不需要 gen-class,只需要编写 Handler。
  • lein-cloverage :用 lein cloverage 运行测试并统计测试覆盖率,支持生成多种格式的报告,可以查看各个命名空间的形式覆盖率(forms coverage)和代码行覆盖率。还可以在生成的 HTML 页面里查看具体哪些语句没有被完全覆盖。
  • lein-cljfmt :用 lein cljfmt 格式化代码。

最后

除了命名空间的概念,Clojure 项目的结构和管理方法与其他软件项目并无太多差异。不过我这里说的「管理」并不是针对人力和时间分配的项目管理,而是指对软件的结构和依赖项的管理。

Clojure 项目比较特殊的是,尽管其他非 Lisp 编程语言可能也有热重载能力,但不像 Lisp 的 REPL 那样灵活。REPL 不只能做到热重载,还允许程序员直接与程序对话,快速上手调试。在项目根目录使用 lein repl 启动 REPL 和 nREPL,项目里所有的命名空间都会被加载,程序员可以在 REPL 里用 ns 在命名空间之间移动,探索软件的内部结构。

既然我们已经掌握了不少 Clojure 的基础知识和项目管理工具,那么是时候来点实操了。下一期我们将会接触到 Ring 及相关的工具,开发简单的 Web 后端。


  1. ns 实际上只是把全局变量 *ns* 设置成了指定的命名空间。 ↩︎

  2. Cheshire 指《爱丽丝梦游仙境》里的「柴郡猫」。cheshire 库用的是 Java 库 Jackson。 ↩︎

  3. 是的,Java 的包名都又臭又长。 ↩︎

  4. 不是说 Java 性能有多好,是因为 Clojure 运行在 Java 之上,自然会有性能损失。 ↩︎

  5. Ring 是 Clojure 的 Web 服务器抽象库;Mock 是指用来测试、演示的假组件,比方说前端需要调用后端 API 进行开发,但后端还没开发完,这时前端就可以用假的 Mock API。 ↩︎

我的乡愁 II

请读者给我几段文本的时间平复心情,我方才忍受着飘散在房间里的烟味儿,下楼给我三个月前带回家的龟背竹换了水。想到刚回家看到它们的模样,我实在没办法平静下来。

因为没办法带上我养的龟背竹,所以放在家里,回家之后…… 它的叶子黄了,边缘已经要枯了,不知道家里人是用什么水养的它,水是褐黄色的,水已经要溢出水瓶了,我明明已经交代过不能超过根部…… 另一盆也半死不活了,因为之前它长得太好了,我给他换了大点的玻璃瓶,想着他能再抽一根叶,那个瓶子被打碎了,被放进了一个塑料桶里,叶子也黄了。你们他妈的对它们做了什么!

—— 我的联邦宇宙账号

清洗它们根部的时候,我感觉自己在看一个受了虐待的孩子。那些根部已经变色变形了,不再是之前漂亮整洁的白色,每次冲洗都会有好多碎屑跟着水流下来。清洗得我觉得能接受了,就给它们倒上了矿泉水。本想放在窗边,但担心被毫不在乎的家人再次打翻,最后还是放回了原位,在那胡乱堆放着食品、香烟和垃圾的茶几上为它腾了一个位子。

读者可能不能理解我为什么对两株植物这么上心。它们是我搬出乌烟瘴气的学生宿舍之后,在出租屋里养得最好的活物。我一直觉得人照料的生命会反映出照料者的生命状态,植物也是。有段时间,我的生活失序,感到十分苦闷,每天回到家就把自己关在房间了,不再活动。直到某天我突然发现我养的龟背竹看起来状态不太对,叶片摸起来不如之前坚挺,我这才意识到自己有多久没给它们换水了。照料它们其实很简单,要把原来的水倒掉,把根部清洗干净,再换上新的水,滴一两滴营养液,再放到能散射到阳光的地方。这些活动需要我走出房间,打开水龙头听见流水的声音,触摸它们的根须和茎叶。渐渐地,我感觉自己也好了起来。

在我对生活相对满意的阶段,被我放在卧室飘窗上的龟背竹突然抽了第三根叶,叶子是很新鲜的嫩绿色,卷卷的。过了不久,又趁我不注意,它的新叶舒展开了,上面的脉络看着很舒服。我记得我当时很开心,它们被我照顾得很好。我喜欢这样的关系,喜欢没有语言的交流。当我要前往另一个城市的时候,我从出租屋里带走了它们,但只能放在父母家。现在,我感到我把它们交给了非常不称职的照顾者。说真的,我怎么可以相信这群连我都没能养好的人呢?这指控主要是针对我爸。

飞机落地前,看到重庆的夜景时,我还有些触动,似乎第一次感到了故乡的熟悉感。我可能有些思乡,但我一点也不念家。上车的时候,我那父亲果不其然问起我有没有交女朋友。他叫我去“把妹”,遇到好看的就去“撩”,要不是我这次掌握了新的沟通技巧(就是在他说这话的时候不理他),他可能要再念叨些油腻的“泡妞技巧”,说起他以前被女生追到躲厕所这个已经被说过无数次且无从考究的辉煌故事。以前我还会写,我吐了,现在我已经没有任何反应。饭桌上,他也犯起爹味来。他从没觉得自己是个糟糕的父亲,从没意识到自己在我的童年和教育中是完全缺席的,看着他把一个个偶然事件包装成成功的教育故事(我大一的时候,他把我送到大学门口,那里车流量大,而且没地方停车,所以他就走了;现在,我是亲近的亲朋好友的孩子中,唯一一个有在上班的,他说起我一个人去外地实习的事情,把那件只把我送到校门口的经历包装成培养我独立性的教育选择,开始觉得自己 鸡巴大起来了 ),我无动于衷,毕竟这事儿他不是第一次干。饭厅的电视上在播放《疯狂动物城》,我就盯着电视看了一晚。我还没看过这部电影呢。

唯一让我不得不动起情绪来的,是他在饭桌上自豪地夸耀起自己把狗摔在地上砸来砸去,把猫的脸摁进尿里,又把它扔得老远的事迹来。他大概觉得欺负无辜(或者照它的说法,是声张正义,不是虐待,因为那狗太黏人,那猫乱尿尿,然而选择黏人品种的是他自己,不及时给猫绝育的也是他)的故事非常值得传诵。回家见到我的龟背竹变成那个样子,我觉得这个家对待生命毫无敬重,而我的父亲还时常跟人抱怨我不念家。我念你妈的家。

国庆前夕,我妈问我什么时候回来,我纠结过后,说我不想回去。我真的不想回这个家。我妈念起过节就是要回来看看家人,念叨着我更觉得烦人,便让她转告我父亲,把他那些乱七八糟的东西从我的书房里收拾掉。我每次回家,都要忍受满是怪味儿和杂物的书房,我爸在抖音直播间买各种“好东西”,但不想弄脏他的房间,于是全放在我那里了。我把房间收拾得尽可能整齐,一些东西实在处理不掉,只能藏起来(我爸说,就放那儿,我能说什么呢,这是他家,不是我家)。他俗不可耐,在书房里放的是很难搬动的中式大椅,和桌子的高度比例也不对,我在那房间里坐着,总是觉得背疼。忍受了这些之后,我离开几个月,再次回来,同样的戏码又要上演一遍,我又得在这个垃圾场里给自己腾地方了。这次回家,书房的确干净了,可我从我爸口中听到的是:你看你妈知道你要回来,把书房收拾得有多干净。我说:那是我要求的。我真想说脏字儿。我可怜我妈,我要的明明是我爸去收拾他自己的烂东西。

现在已经到了凌晨一点,我爸在我的房间外面打游戏,和某个女的语音通话,笑声很蠢。耳塞都隔不开他的愚蠢。他完全没有考虑过他的声音和游戏的声音会打扰到家里任何人休息,我能说什么呢,这是他家,不是我家。

这是他家,不是我家。他没有也没想过给我留位置,我有自知之明。

乡愁是驱使我找到工作,独立生活的唯一动力。我要逃离这个是非之地,我要有腰包和底气对这个男人说不,我可以说“老子就是不要回你的家”。我要有自己的房子,把我的龟背竹养好,等他的新芽长好长实,移植出好几盆,把它们交给可靠的人。那只被我爸摔过的狗今晚在我姑姑的怀里睡得很安心,她做这个男人的姐姐真的承受了很多。我会养一只狗狗,我永远也不要打它骂它,我要让他在我的怀里安安静静地睡去,我也安心入眠。第二天,阳光会洒在我们所有人身上。

Coffee Break Clojure, Functional

今天的文章衔接 上一期 有关集合(collection)和序列(sequence)的知识,来讨论一种特殊的集合,叫惰性序列(lazy seq)。我们还会接触到函数式编程(functional programming)。

其实在另一门名为 Haskell 的语言里,也能见到惰性,而 Haskell 是纯函数式的编程语言(Clojure 在很多方面都不如 Haskell 严格)。函数式和惰性非常契合,可以说没了惰性,函数式就不够务实,会消耗更多的计算资源。

编程范式

编程范式(programming paradigm)可以理解为编程方法论。用我的方法解释的话,一套编程范式提供了一系列高度抽象的逻辑组件、通用的程序结构,比方说 for 循环结构就是 结构化编程 (structrual programming)这一范式提出的。

结构化编程的主要主张是 goto 语句有害论,由 Dijkstra 在 1968 年提出。这在当时颇有争议,不过如今已成公理,如今的新来者可能根本不会听说 goto 语句。我也从来没写过,我了解到 goto 的时候,我的 C 语言老师就严肃地告诉我们不该用 goto。

据 Robert C. Martin 在《 架构整洁之道 》里总结,结构化编程本质上限制了程序控制权的直接转移,即不允许用 goto 语句直接变更程序的执行位置。要转移程序的执行位置,只能用块结构1表示条件判断、循环体等等。块结构使得程序可以被清晰地划分为可理解的部分,而不是一条一条分散的代码。

面向对象编程(object-oriented programing,后称 OOP)在块结构之上提出了新的组织程序的方式,也就是对象(之所以不说「类」,是因为也有无类 OOP,比如 基于原型的编程 )。程序员经常需要定义一种数据类型,然后定义对这种数据类型的操作(封装);对不同的类型和不同的输入而言,相同的操作可能有不同的行为(多态);数据类型的某些操作是共通的,可以复用(继承)。OOP 引入了更高层的概念和结构。据 Martin 所言,OOP 本质上是限制了对程序控制权的间接转移,因为 OOP 用方法(method)代替了函数指针(function pointer)。2

Martin 认为编程范式并没有引入新的东西,反而是提出了更多的限制,比如限制 goto 语句和限制函数指针。函数式编程(后称 FP)范式引入的限制是:禁止赋值语句。是的,不允许给变量赋值,所以在前四篇里我们一次都没有见到 Clojure 的赋值语句,只见到了定义符号的语句。

为什么?因为给变量赋值就意味着我们在维护一个可变的状态,而状态在 FP 看来是个坏东西:

  1. 如果系统有多个状态,复现 Bug 时,需要复原系统中所有的状态。
  2. 有多个读者和写者时,为保证数据一致性和完整性,需要加锁,而维护锁很痛苦3。更何况锁本身也是一个新的状态!
    • 说到这里,容许我插一嘴,我前不久修复了一个非常诡异的 Bug,最后我们发现问题出在系统里某个地方加了锁。这个锁是外部的某个库引入的,我们完全不知道那个锁的存在。当时系统出现了大量的超时错误,我们以为是网络阻塞,结果竟然是大量请求等待锁导致的。
  3. 管理状态如何在系统的各个部分之间同步和转移,定义状态如何变更,检验状态的有效性等等,都会极大提升系统的复杂度。

这其实也在逐渐成为共识,我们看到很多编程语言(比如 Rust)的变量默认不可变(immutable)。状态更少会让复杂系统更容易维护,而 FP 则致力于消除可变状态。

不过整体而言,FP 并不主流。不少人对 Haskell 的第一印象是「学术语言」(一开始的确是)。Haskell 的标语是「Enjoy long-term maintainable software you can rely on」(享受你可以依靠的长期可维护的软件),这显然是出于工程考虑写下的标语。

在过去,FP 受到的不认可往往源自于它的性能问题。由于 FP 系统不维护状态,而是在函数的相互调用之间传递参数,循环结构也往往用递归(recursion)表示,这就导致处理大量数据时,函数栈帧会占用大量内存,而且可能出现栈溢出问题。不过这个问题现在已经有了应用广泛的解决方案,叫作尾部调用优化(Tail Call Optimization,TCO)——简单来说,只要递归函数调用发生在函数尾部,编译器或解释器就可以复用上一个递归调用的栈帧,把递归调用变成循环结构,但语言层面仍然是递归写法。

深入函数式

FP 不仅禁止赋值语句,还避免副作用(side effects)。FP 把函数想象成和数学函数一样的东西,输入值,然后输出值,这其间不该发生别的事情,比如不该修改系统中其他的状态。

那 FP 程序怎么和外部设备交互呢?照其定义,I/O 操作也是副作用,我还不能把数据写入磁盘了吗?其实,一般只有纯函数式语言才会想要完全消除副作用,Haskell 是通过引入 IO 单子 的概念消除副作用的。Haskell 把对外部状态的访问和操作当作显式的作用,而非副作用。至于 Clojure,它并不是纯函数式语言。副作用是允许的,只是不鼓励。Scheme 也允许副作用,因此 Scheme 更喜欢用 procedure(过程)这个词表示 function,因为有副作用的不是纯函数。

与副作用相关的概念是引用透明性( referential transparency ),可以说避免副作用就是为了实现引用透明性。以下面这段 Clojure 代码为例:

(+ (- 3 1) 4)
;; => 6 

;; 上述代码应该和下面这段代码等价 
(+ 2 4)
;; => 6

;; 上述代码应该和下面这段代码等价 
6 
;; => 6

函数调用可以显式地替换为它的返回值,这就是引用透明性。对数学运算来说这理所应当,FP 要求的就是把这种「理所应当」也应用在其他计算机程序上。没有引用透明性的函数是什么样的?

var x = 0
function add(a, b) {
 x = x + 1
 return a + b
}

add(add(x, x), x)
// => 1

上述 add() 是个闭包函数(因为它访问了外部作用域的 x 变量),每执行一次 add() 都悄悄地给 x 加 1,然后再返回 a + b。

执行 add(add(x, x), x) 的结果是 1。调用最外层的 add() 之前,我们先要得到参数的值。第一个参数是函数调用,求出值为 0,同时 x 的状态变成了 14;然后将 0 作为第一个参数传入,此时求 x 的值,发现是 1,将 1 作为第二个参数传入,也就是 add(0, 1)。最后函数返回了 1,x 的值变成了 2。

假设现在 x 的值还是 0,我们把 add(x, x) 换成理应等价的 0,发现 add(0, x) 得到的是 0 而不是 1。这个程序没有引用透明性,而且 x 的状态不可控,add() 的结果难以预测。

不难意识到避免副作用对系统的长期可维护性的好处。如果我们非要一个 x “变量”作为计数器,记录调用 add() 函数的次数,不妨用递归实现。

const numbers = [2, 4, 3, 7, 2, 7, 5, 10, 3]

function addWithCounter(numbers, counter, total, index) {
 if (numbers.length - 1 < index) {
 return {counter: counter, total: total}
 }
 return addWithCounter(numbers, counter+1, total + numbers[index], index+1)
}

addWithCounter(numbers, 0, 0, 0)
// => {counter: 9, total: 43}

上面这段代码是函数式的。const 是常量声明,而不是赋值。在 addWithCounter() 中我们只是返回计算后的值,将某些“状态”作为函数参数递归地传递,没有可变状态。我们在不使用循环结构的情况下遍历累加了数组,并且维护了一个 counter(计数器)。

在 Clojure 中,可以用 loop 构造递归,无需声明函数:

(defn addWithCounter [numbers]
 (loop [counter 0, total 0, index 0]
 (if (< (count numbers) (inc index))
 {:counter counter :total total}
 (recur (inc counter) (+ total (numbers index)) (inc index)))))

(addWithCounter [1 2 3])
;; => {:counter 3, :total 6}

不过更好的写法是用利用惰性。

;; reductions 类似于 reduce
;; 但返回的是每个步骤的 lazy seq,而不是最终结果 
;; (= (reduce f coll) (last (reductions f coll)))
(defn addWithCounter [numbers]
 (let [steps (reductions + numbers)]
 {:counter (count steps)
 :total (last steps)}))

(addWithCounter [1 2 3])
;; => {:counter 3, :total 6}

reductions 函数返回的是惰性序列,其实上一篇提到的 map 返回的也是惰性序列。这究竟是什么东西?

初识惰性

lazy-seq 函数接收一系列表达式,这些表达式最终返回一个序列。不过,写在 lazy-seq 里面的表达式并不会被立即执行,而是会在 lazy-seq 被访问时执行。也就是说,lazy-seq 保存了一系列「如何求值」的步骤,仅在每个步骤被访问时才计算具体的数值。

还记得序列(sequence)的定义吗?仅支持线性访问的集合。还记得 Cons 吗?一个序列就是保存了第一个值(_first)和指向下一个 Cons 的“指针”(_next)的对象。假如序列的 next 并不指向下一个 Cons,调用它的 next() 方法时,它并不 return _next,而是调用函数计算下一个值再返回,调用几次 next() 就计算几次值。

听起来像个迭代器(Iterator),两者确实很像。惰性序列就是可以当作序列处理的迭代器,不过我们并不需要手动调用 next,只需要正常地把它当作序列处理,剩下的 Clojure 会帮我们解决。

对一个 Lazy Seq 分别调用一次 first 和两次 next 函数的示意图

作为演示,我们先定义一个指向无穷的符号。

(def ∞ (range))
;; => #'user/∞

(type ∞)
;; => clojure.lang.Iterate

range 可以返回指定范围的整数序列,如果不给参数的话,就会返回 Iterate 对象。可以把 Iterate 理解为做了特殊优化的 LazySeq,使用起来和惰性序列区别不大。

我们试试从「无穷」中取出前五个数:

(take 5 ∞)
;; => (0 1 2 3 4)

只想要正整数?没问题。

(def ℤ (map inc ∞))
;; => #'user/ℤ

(take 5 ℤ)
;; => (1 2 3 4 5)

只想要偶数?当然!

;; 其实我本来想用 {2k|k∈ℤ} 做符号名,可惜不合法
(def even-numbers (filter even? ℤ))
;; => #'user/even-numbers
;; or 
(def even-numbers (map #(* 2 %) ℤ))
;; => #'user/even-numbers

(take 5 even-numbers)
;; => (2 4 6 8 10)

但要注意,有些操作不能应用在无穷的惰性序列上,比如 shuffle,这个函数的作用是打乱一个序列,但你怎么打乱「无穷」呢?想想就需要无穷的计算时间。此外还有 sort、group-by 和 count。

图片来自: Clojure’s Deadly Sin

等等,count?难道之前不是说 count 的时间复杂度为 O(1),只需要 return _count 就好了吗?对惰性序列来说不是这样,因为在把所有可能性都实现之前,惰性序列自己也不知道自己有多长。

// package clojure.lang
// LazySeq 的 count 方法
public int count(){
	int c = 0;
	for(ISeq s = seq(); s != null; s = s.next())
		++c;
	return c;
}

惰性序列和迭代器的另一个区别是,惰性序列会缓存已经计算的值,再次访问时会使用已有的值,不会重复计算。可以用 realized? 函数检查序列有没有被计算。

(realized? (range))
;; => true
(realized? (rest (range)))
;; => false

(range) 本身作为一个 Cons,包含 0 的初始值,但它之后的 Cons 都还没有被计算,所以返回 false。注意 (realized? (first (range))) 实际上是 (realized? 0),会报错,因为 Long 类型没有是否被实现之分。

练习函数式与惰性

接下来我会提出一些需求,读者可以在自己的 REPL 里编写 Clojure 代码实现,我会把参考答案附在题目后面。题目中还会包含一些新的 Clojure 函数的用法介绍,读者可以一边练习一边学习新函数。

凯撒密码

凯撒密码是一种替换加密,即简单地把明文中的每个字母替换为字母表往后偏移 N 个字母之后的字母。比如,如果偏移量是 3,A 就会被换成 D。

凯撒密码示意图

我们知道 ASCII 编码中,65 对应的是大写字母 A,90 对应 Z。如果要将 A 变成 D,只需要对字符的十进制数表示加 3,然后再转换成字符。

在 Clojure 中,可以调用 Java 方法把数字转换为 ASCII 字符串:

(Character/toString 65)
;; => "A"
(Character/toString (+ 65 3))
;; => "D"

可以用 zipmap 函数把两个序列封装成映射,第一个序列的元素作为键,第二序列的元素作为值。

(zipmap ["A" "B" "C"] ["D" "E" "F"])
;; => {"A" "D", "B" "E", "C" "F"}

range 可以指定序列的范围:

(range 65 91)
;; => (65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90)

使用 range、map 和 zipmap 构造出偏移量为 5 的凯撒密码对照表。

参考答案
(defn caesar-map [offset]
 (let [alphabet (map Character/toString (range 65 91))
 ciphered (concat (drop offset alphabet) 
 (take offset alphabet))]
 (zipmap alphabet ciphered)))
(caesar-map 5)
;; => {"T" "Y", "K" "P", "Q" "V", "L" "Q", "G" "L", "J" "O", "M" "R", "S" "X", "Y" "D", "Z" "E", "H" "M", "E" "J", "R" "W", "C" "H", "F" "K", "B" "G", "P" "U", "V" "A", "U" "Z", "O" "T", "X" "C", "N" "S", "A" "F", "I" "N", "W" "B", "D" "I"}

(get (caesar-map 5) "A")
;; => "F"

钩子

系统的业务逻辑里有几个关键节点设置了钩子,在特定事件发生时可以执行用户自定义的函数,像这样:

(defn process-large-data [hooks data]
 (let [todo (map process-data (filter valid? data))]
 (if (seq todo)
 ;; todo 非空的时候,执行 todo
 ;; 然后调用 hooks 里的 :on-finish 函数
 (do (doall todo)
 ((:on-finish hooks)))
 ;; todo 为空,即没有要处理的数据 
 ;; 调用 hooks 里的 :on-empty 函数
 ((:on-empty hooks)))))

todo 是 filter 和 map 返回的惰性序列,如果没有被访问就不会执行 process-data。之后通过 seq 检查 todo 是否非空,如果是的话就 doall,这个函数可以执行惰性序列中所有的元素。外层的 do 用来把多个表达式放在一个形式(form)里,不然会被 if 当作多个参数处理。
hooks 是长这样的映射。

{:on-finish (fn [] (println "Finished processing"))
 :on-empty (fn [] (println "Todo is empty"))}

(:on-finish hooks) 把函数从映射里取出来,((:on-finish hooks)) 先把函数取出来,然后执行这个函数。

可以使用 merge 函数将两个映射合并,如果有相同的键,用后一个映射覆盖:

(merge {:a 1 :b 2 :c 3} {:a 2 :b 1})
;; => {:a 2, :b 1, :c 3}

repeat 函数返回重复同一个值的序列,如果不指定重复的次数,就会返回无限长的惰性序列。

(repeat 5 "hello")
;; => ("hello" "hello" "hello" "hello" "hello")

(take 5 (repeat "hello"))
;; => ("hello" "hello" "hello" "hello" "hello")

(repeat "hello")
;; 如果直接访问这个惰性序列
;;(比如:在 REPL 里输入,REPL 会 print 这个序列)
;; 就会造成死循环,(range) 也是同理

使用 merge、repeat 和 zipmap 编写 make-hooks 函数,接收 user-hooks 参数,user-hooks 和上文的 hooks 结构相同,但键可能不全。默认情况下,hooks 中的钩子函数不做任何操作(println 也不能有),除非用户传入了钩子函数。

参考答案
(def hook-keys [:on-finish :on-empty])

(def default-hooks 
 (zipmap hook-keys (repeat (fn []))))

(defn make-hooks 
 ([] default-hooks)
 ([user-hooks]
 (if (seq user-hooks)
 (select-keys 
 (merge default-hooks user-hooks)
 hook-keys)
 default-hooks)))

select-keys 只选择映射中指定的键,如果用户提供了不存在的键,可以用这个函数筛掉。不过不筛问题也不大,反正多余的钩子也不会被调用。

无重复的随机数序列

repeat 函数重复值,repeatedly 函数可以重复执行函数,返回惰性序列。(rand-int n) 返回 [0, n) 区间内的随机整数。5

(take 5 (repeatedly #(rand-int 100)))
;; => (72 56 54 21 89)

loop 和 recur 刚才我们已经见过了。可以把 loop 里类似 let 绑定的向量当作函数的参数和初始值之间的绑定,而 recur 则是递归地调用 loop,recur 的参数数量应该和 loop 的绑定数量相同。

(loop [arg1 0, arg2 "any value" arg3 :not-over]
 (if (> arg1 10)
 {:arg1 arg1 :arg2 arg2 :arg3 :over}
 (recur (inc arg1) "any value" :not-over)))
;; => {:arg1 11, :arg2 "any value", :arg3 :over}

使用任何你能想到的函数,编写 uniquely-rand-int 函数,接收参数 n 和 t,返回由 n 个小于 t 的不重复的随机整数序列。

参考答案

第一种解法,使用 loop 并拒绝已经存在的元素。

(defn uniquely-rand-int [n t]
 (loop [result '()]
 (if (>= (count result) n)
 result
 (let [randint (rand-int t)]
 (if (some #{randint} result)
 (recur result)
 (recur (conj result randint)))))))

第二种解法,使用 set,利用集的特性去重。

(defn uniquely-rand-int [n t]
 (loop [result #{}]
 (if (>= (count result) n)
 (seq result)
 (recur (conj result (rand-int t))))))

第三种解法:

(defn uniquely-rand-int [n t]
 (->> (range t) shuffle (take n)))

第三种解法不仅更简洁,而且不会出现死循环。试一试,如果是前两种解法,在 t 比 n 小的情况下就会出现死循环,但第三种解法只会返回数量不足的序列。

(uniquely-rand-int 5 10)
;; => (6 8 1 3 9)
(uniquely-rand-int 5 1)
;; => (0)

而且第三种解法的时间复杂度是 O(n),瓶颈主要在 shuffle,这个函数底下用的是 Java 的 Collections.shuffle, 时间复杂度为 O(n) 。


  1. 比如 C 语言中 {} 包裹的块。 ↩︎

  2. 不过我对这个说法存疑,因为 C++ 作为 OOP 语言,甚至有方法指针(method pointer)这种东西。 ↩︎

  3. Go 语言的 channel 其实用 FP 以外的方式解决了这个问题 ↩︎

  4. 为什么这个 add(x, x) 没有受到 x = 1 的影响?因为函数的参数是作为值传入的,不是变量引用。add() 接收到的就是两个 0 而不是两个 x。 ↩︎

  5. 你可能注意到了:是的,rand-int 不具有引用透明性,不是函数式的,除非确定种子。 ↩︎

❌